

Com o aumento constante do custo dos vazamentos de dados e a preferência dos invasores por alvos como painéis administrativos, portais de clientes, dashboards e APIs, um controle de acesso mal configurado pode rapidamente resultar em perda de informações, quebra de confiança e prejuízos financeiros expressivos. O mais preocupante é que, na maioria dos casos, as falhas não envolvem técnicas sofisticadas, mas sim erros simples: verificações de permissão ausentes, papéis de usuário com privilégios excessivos ou identificadores previsíveis em URLs.
Este artigo explica como funciona o controle de acesso, por que ele é essencial para a segurança de sites e sistemas, e como é possível reduzir riscos sem comprometer a usabilidade da plataforma.
O que é controle de acesso, afinal?
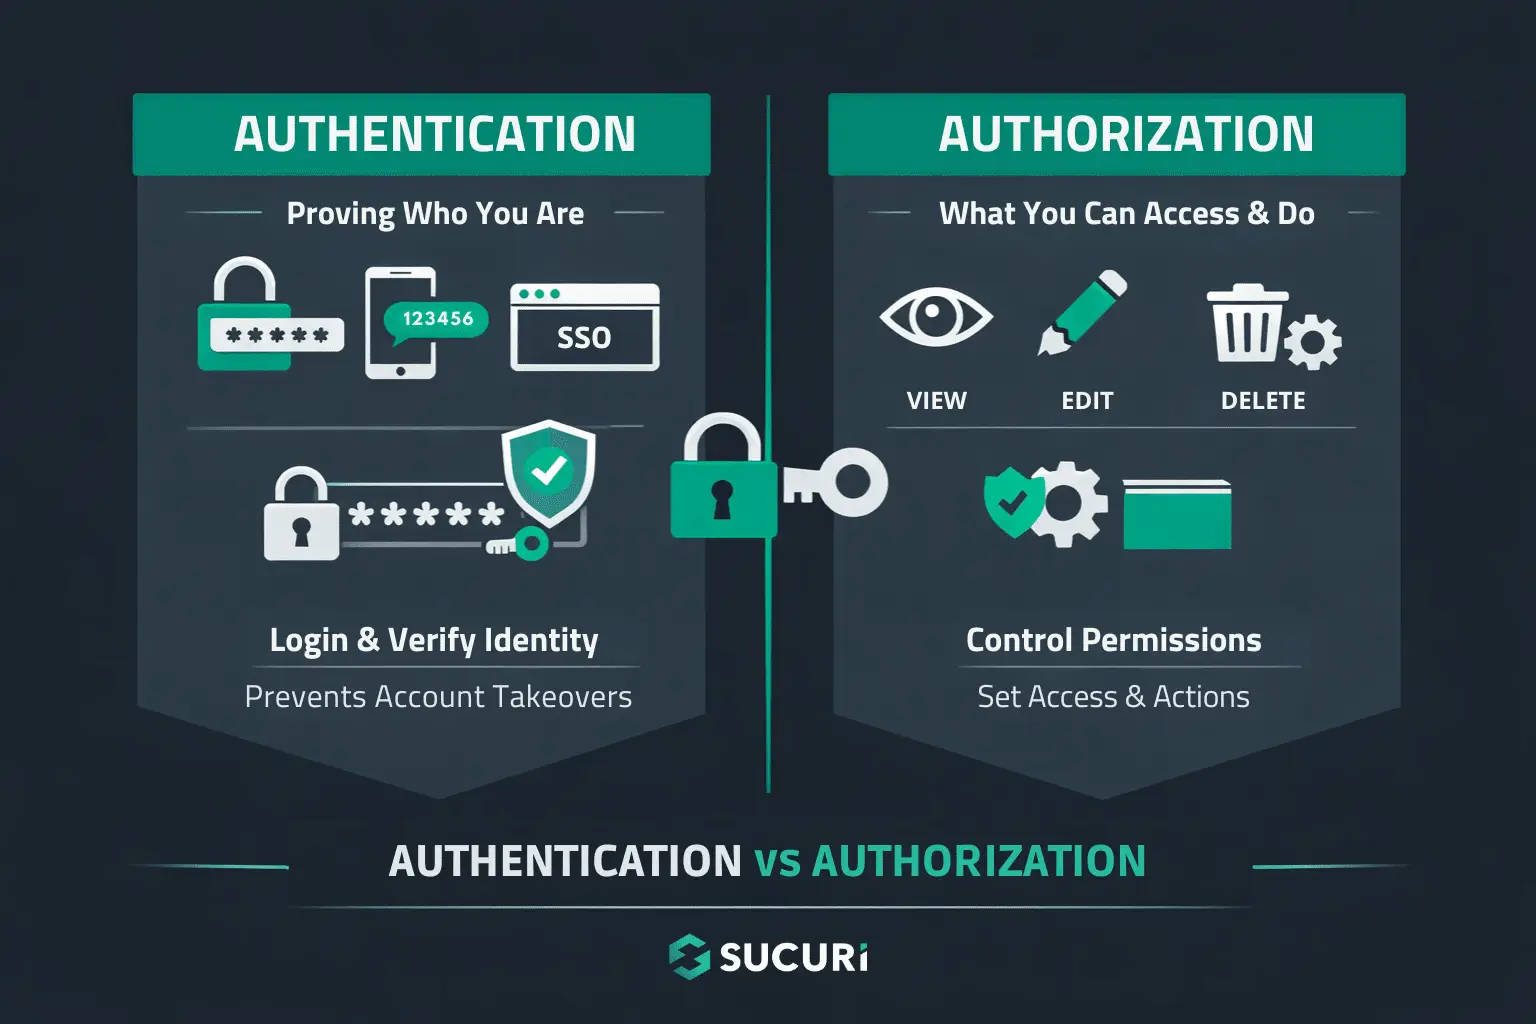
Controle de acesso é o conjunto de regras e ferramentas responsáveis por definir quem pode utilizar um sistema e o que essa pessoa está autorizada a fazer depois de entrar nele. Na segurança web, esse conceito normalmente combina autenticação — que verifica a identidade do usuário — com autorização, que concede permissão para visualizar dados ou executar ações. Além disso, inclui as verificações que garantem que essas permissões sejam respeitadas de forma consistente em páginas, APIs e serviços internos.
Autenticação e autorização não são a mesma coisa
Esses dois termos representam etapas distintas do processo de segurança. Para uma proteção realmente eficaz, é fundamental tratá-los separadamente.
Autenticação responde à pergunta “quem é você”. É a etapa de login, feita por senhas, passkeys, códigos de uso único, SSO ou autenticação multifator. Uma autenticação forte ajuda a evitar a invasão de contas, mas, por si só, não protege tudo o que acontece depois que o usuário entra no sistema.
Autorização, por sua vez, determina “o que você pode fazer”. Uma vez autenticado, é a autorização que decide o que o usuário pode visualizar, criar, editar, excluir ou gerenciar — permissões como “ver faturas”, “editar produtos” ou “gerenciar usuários”.
Uma boa forma de visualizar essa diferença é imaginar a autenticação como a apresentação de um documento na entrada de um estabelecimento, enquanto a autorização seria o segurança decidindo se aquela pessoa pode entrar na área VIP, ir até o bar ou acessar o caixa. Um site seguro precisa das duas camadas, aplicadas de forma consistente. Se mesmo um único endpoint deixar de verificar a autorização, invasores conseguem, muitas vezes, contornar os controles visuais da interface e acessar dados sensíveis diretamente por URLs ou chamadas de API que não deveriam estar disponíveis.
Um erro comum é presumir que “estar logado” equivale a “ser confiável”. Grande parte dos ataques parte de contas legítimas — sejam usuários comprometidos, funcionários com permissões além do necessário ou clientes testando os limites do que conseguem acessar. Por isso, a abordagem mais segura é exigir que cada requisição comprove ter permissão para a ação, e não apenas uma sessão válida.
Em sistemas de identidade mais modernos, também é recomendável ajustar o nível de exigência da autenticação conforme o risco envolvido. Por exemplo, exigir autenticação multifator para ações administrativas, conforme orientações de identidade digital como as do NIST SP 800-63-4.
Os três principais modelos de controle de acesso
Na prática, a maioria dos sistemas web adota um modelo principal como base e incorpora elementos de outros modelos conforme a necessidade. Veja um panorama:
- Controle de Acesso Discricionário (DAC): o próprio dono do recurso decide quem pode acessá-lo — como ao compartilhar um documento com pessoas específicas. Em aplicações web, aparece quando usuários definem visibilidade (“privado”, “equipe” ou “público”) ou compartilham itens com terceiros. É flexível, mas arriscado quando as configurações padrão de compartilhamento são muito abertas ou quando a “propriedade” de um recurso pode ser falsificada, abrindo espaço para falhas do tipo IDOR.
- Controle de Acesso Obrigatório (MAC): aplica regras de acesso baseadas em políticas gerenciadas centralmente, que os usuários não podem alterar. É comum em ambientes de alta segurança, nos quais os recursos recebem classificações de sensibilidade e o acesso é rigidamente controlado. Na web, esse modelo aparece em sistemas que impõem fronteiras rígidas, como zonas de dados regulados ou isolamento entre clientes (tenants). O MAC pode ser muito seguro, mas exige uma gestão de políticas mais complexa.
- Controle de Acesso Baseado em Função (RBAC): atribui permissões a funções — como Administrador, Suporte, Editor ou Financeiro — e, em seguida, associa os usuários a essas funções. É o modelo mais utilizado em sites e produtos SaaS justamente por sua escalabilidade: basta incluir um usuário em uma função para que ele receba as capacidades correspondentes. O RBAC funciona melhor quando as funções refletem cargos reais, são mantidas enxutas e seguem o princípio do menor privilégio, concedendo apenas o acesso necessário.
Para quem está construindo um portal de clientes, um fluxo de CMS ou uma API usada por múltiplos clientes, o RBAC costuma ser o ponto de partida mais indicado, podendo receber camadas adicionais de contexto conforme a necessidade.
Por que o controle de acesso é tão importante para a segurança web atual
O controle de acesso é o que separa “um usuário está logado” de “um usuário tem permissão para fazer exatamente isto com exatamente estes dados”. Quando essa barreira é fraca ou inconsistente, os atacantes não precisam quebrar criptografias nem instalar malware: basta explorar verificações de permissão ausentes, identificadores previsíveis ou funções com poder excessivo. Não é à toa que o “Broken Access Control” continua figurando entre os principais riscos de aplicações web.
Em sites modernos, a superfície de ataque vai muito além do painel administrativo. Portais de clientes, dashboards SaaS, endpoints de CMS headless, aplicativos móveis e APIs públicas se tornam alvos em potencial, especialmente quando a lógica de negócio evolui rapidamente e as verificações de autorização acabam duplicadas — ou esquecidas — entre diferentes serviços. Até mesmo usuários bem-intencionados podem causar danos quando as permissões são amplas demais, provocando exclusões acidentais, exposição indevida de dados ou alterações que enfraquecem silenciosamente as configurações de segurança.
Um controle de acesso robusto também fortalece a resiliência do dia a dia: reduz o raio de impacto quando contas são comprometidas, torna a resposta a incidentes mais clara, já que permissões e ações ficam rastreáveis, e dá às equipes mais segurança para operar à medida que funcionários, prestadores e integrações mudam ao longo do tempo.
Em resumo, o controle de acesso protege mais do que dados: conceder, gerenciar e revogar acessos deve ser uma disciplina contínua, não uma configuração feita uma única vez — é isso que preserva fronteiras, responsabilidade e a confiança que os usuários depositam no site a cada clique em “Entrar”.
Como implementar mecanismos eficazes de controle de acesso
Um controle de acesso bem feito não depende de termos da moda, mas sim da construção de um sistema consistente, testável e difícil de burlar. A interface visual do site não é a verdadeira barreira de segurança — quem cumpre esse papel são as verificações de autorização feitas no lado do servidor. Toda requisição, seja o carregamento de uma página, uma chamada de API ou uma tarefa em segundo plano, deveria ser avaliada por uma política clara: este usuário tem permissão para executar esta ação, sobre este recurso, neste contexto específico?
O ideal é começar com um modelo simples, capaz de ser explicado a um novo desenvolvedor em poucos minutos, e expandi-lo conforme a necessidade surgir. A maioria das equipes se sai bem adotando o RBAC para permissões básicas, somado a regras extras para ações sensíveis — como exigir autenticação multifator para alterações de conta ou restringir exportações de dados a determinadas funções. Também é importante documentar as regras, centralizar a lógica de autorização em vez de espalhá-la por diferentes controladores, e criar testes automatizados que verifiquem tanto os casos permitidos quanto os negados.
Um exemplo prático de estrutura RBAC pode ser organizado assim:
- Administrador: gerencia usuários, cobranças, configurações de segurança e integrações.
- Editor: cria e atualiza conteúdo, mas não pode alterar configurações de segurança.
- Visualizador: acesso somente leitura a páginas e relatórios aprovados.
O RBAC pode falhar, por exemplo, se a função de “Editor” acabar recebendo acesso à gestão de usuários sem que isso tenha sido planejado, ou se um “Visualizador” conseguir alcançar endpoints ocultos que permitem exportar dados. Para evitar esse tipo de problema, Plustag IA recomenda algumas boas práticas:
- Desenhar as funções com base em cargos reais, e não em títulos simbólicos como “usuário avançado”.
- Aplicar o princípio do menor privilégio desde o início, concedendo acessos de forma intencional e gradual.
- Exigir privilégios mais altos — e, idealmente, autenticação mais forte — para ações sensíveis, como exportações, mudanças de permissão e criação de chaves de API.
- Tratar cada função como um contrato: toda alteração deve ser registrada, revisada e testada novamente.
Para sites que utilizam WordPress ou outros sistemas de gerenciamento de conteúdo semelhantes, as funções de usuário já vêm incorporadas à plataforma, mas isso não dispensa a atenção redobrada: é preciso revisar periodicamente quem tem acesso a quê, eliminar permissões acumuladas ao longo do tempo e garantir que plugins e integrações não abram brechas silenciosas no controle de acesso. No fim das contas, proteger um site vai muito além de blindar a tela de login — exige tratar cada permissão concedida como parte ativa da estratégia de segurança.
Com informações de blog.sucuri.net.