

O uso de dados estruturados, conhecido como schema markup, não garante que sistemas de inteligência artificial citem um site diretamente. No entanto, essa técnica ajuda mecanismos de busca como Google e Bing, além de ferramentas de IA generativa como o ChatGPT, a entender melhor quem é uma empresa, verificar suas informações e decidir se ela merece destaque nos resultados. Essa é a conclusão de uma análise apresentada durante uma sessão da série SEJ Pro Keystone, dedicada a estrutura de conteúdo e schema, que reforçou a importância da validação dos dados — etapa frequentemente negligenciada por quem trabalha com otimização de sites.
A comparação usada para ilustrar o conceito é a de um perfil em aplicativo de relacionamento: o schema funciona como a primeira apresentação de uma marca para os buscadores, contendo informações sobre o conteúdo, a empresa e as pessoas envolvidas. Se o que está descrito nesse “perfil” não corresponde à realidade encontrada por quem visita o site, o efeito é semelhante ao de um perfil falso — e isso prejudica a relação de confiança tanto com usuários quanto com os algoritmos do Google ou do ChatGPT.
Schema não cria confiança, mas permite comprová-la
Diferentemente do que muitos profissionais de SEO acreditam, o schema não funciona como um botão que melhora automaticamente o posicionamento nas buscas. Seu papel real é diferenciar uma entidade de outras semelhantes, confirmar informações e viabilizar a exibição de resultados enriquecidos.
Empresas de tecnologia têm sido mais específicas sobre isso do que boa parte do mercado de SEO. A Microsoft já afirmou que o schema auxilia seus modelos de linguagem a compreender o conteúdo das páginas. O Google, por sua vez, orienta que os dados estruturados não são obrigatórios para os recursos de IA, mas recomenda seu uso como parte de uma estratégia de SEO completa. Já a OpenAI destaca que dados estruturados de produtos alimentam diretamente o que o ChatGPT apresenta a consumidores em buscas de compra.
Ou seja: o schema é útil, mas não resolve tudo sozinho. Ter a marcação implementada não é garantia de resultado, já que os buscadores comparam essas informações com o conteúdo real da página, o feed de produtos da empresa, avaliações e o que é dito sobre a marca em outros canais. A recomendação é priorizar consistência entre todas as propriedades usadas, em vez de simplesmente acumular o maior número possível de marcações.
Quatro fontes de informação precisam estar alinhadas
Segundo a análise, praticamente todos os modelos de negócio avaliados dependem da coerência entre quatro elementos:
- A página do site: as informações visíveis para quem acessa o conteúdo.
- O schema: a versão dessas mesmas informações em formato legível por máquinas.
- A plataforma oficial de referência: o Google Business Profile, no caso de negócios locais, ou o Merchant Center, para lojas virtuais.
- Confirmações externas: avaliações, diretórios, perfis profissionais, publicações e estudos.
Quando essas quatro fontes contam a mesma história, cria-se um ponto de referência confiável para os mecanismos de busca. Quando há divergências, uma marcação sofisticada pode até prejudicar a credibilidade do site em vez de reforçá-la.
Por isso, detalhes pequenos importam. Usar “Suite” no site e “Ste” no schema, por exemplo, gera uma inconsistência que pode ter impacto real. O mesmo vale para divergências no nome da empresa, telefone, horário de funcionamento, código SKU, preço, cargo ou nome de autor entre diferentes canais, sem explicação para a mudança.
Schema local: tudo gira em torno da entidade
Para negócios com endereço físico, a entidade é o ponto de partida de toda a estrutura de dados — sem ela, não há schema local, pois as demais propriedades precisam de uma referência. A análise identificou nove pilares nesse processo, começando pela entidade e seu identificador estável, passando por nome, endereço e telefone (NAP), coordenadas geográficas, horários, serviços, ações de conversão, avaliações, links sameAs e consistência geral.
Uma das principais fontes de confusão está na área de atendimento. No Google Business Profile, o campo “área de atendimento” indica para onde a empresa entrega ou se desloca, não todos os locais em que atua. Já no schema, a propriedade areaServed representa todas as regiões atendidas — são campos diferentes, que respondem perguntas diferentes. Em cidades com múltiplas unidades ou bairros, reutilizar a mesma marcação genérica para todos pode eliminar distinções importantes para que o mecanismo de busca recomende a unidade certa.
Um teste prático ilustrou esse ponto: ao perguntar ao ChatGPT por um fisioterapeuta em Hoboken, nos Estados Unidos, aberto naquele dia, a ferramenta retornou a marca de um cliente, com horários e serviços como reabilitação ortopédica, lesões esportivas e recuperação pós-cirúrgica. Essas informações não estavam na página daquela unidade específica, mas sim no schema e no perfil comercial do Google — duas das três fontes continham os dados, o suficiente para o ChatGPT tomar a decisão.
Isso não significa que informações relevantes devam ficar escondidas apenas nos dados estruturados — o conteúdo visível continua sendo a base de tudo. Quando as fontes estão alinhadas, o mecanismo de busca consegue identificar corretamente o negócio e associá-lo a necessidades específicas sem depender de suposições.
Schema para e-commerce
Para lojas virtuais, a lógica é semelhante, mudando apenas a plataforma de referência: o feed do Merchant Center deve ser o espelho mais fiel possível do schema, campo a campo. Isso inclui atenção redobrada a dados como nome, descrição, marca, imagens, SKU, MPN, GTIN e um identificador consistente, além de informações da oferta, como preço, moeda, condição do produto, disponibilidade, custo de frete, prazo de entrega, política de devolução e variações do produto.
Problemas de disponibilidade podem impactar diretamente a receita. Quando o schema muda para “fora de estoque” no exato momento em que o inventário zera, isso sinaliza ao Google que o item não é mais vendido — e o ranking conquistado pode ser perdido, mesmo que o produto volte ao estoque pouco tempo depois. Utilizar corretamente os valores do Schema.org para status temporários ajuda a comunicar essas mudanças com mais precisão, sendo, muitas vezes, mais relevante do que outros detalhes de propriedade.
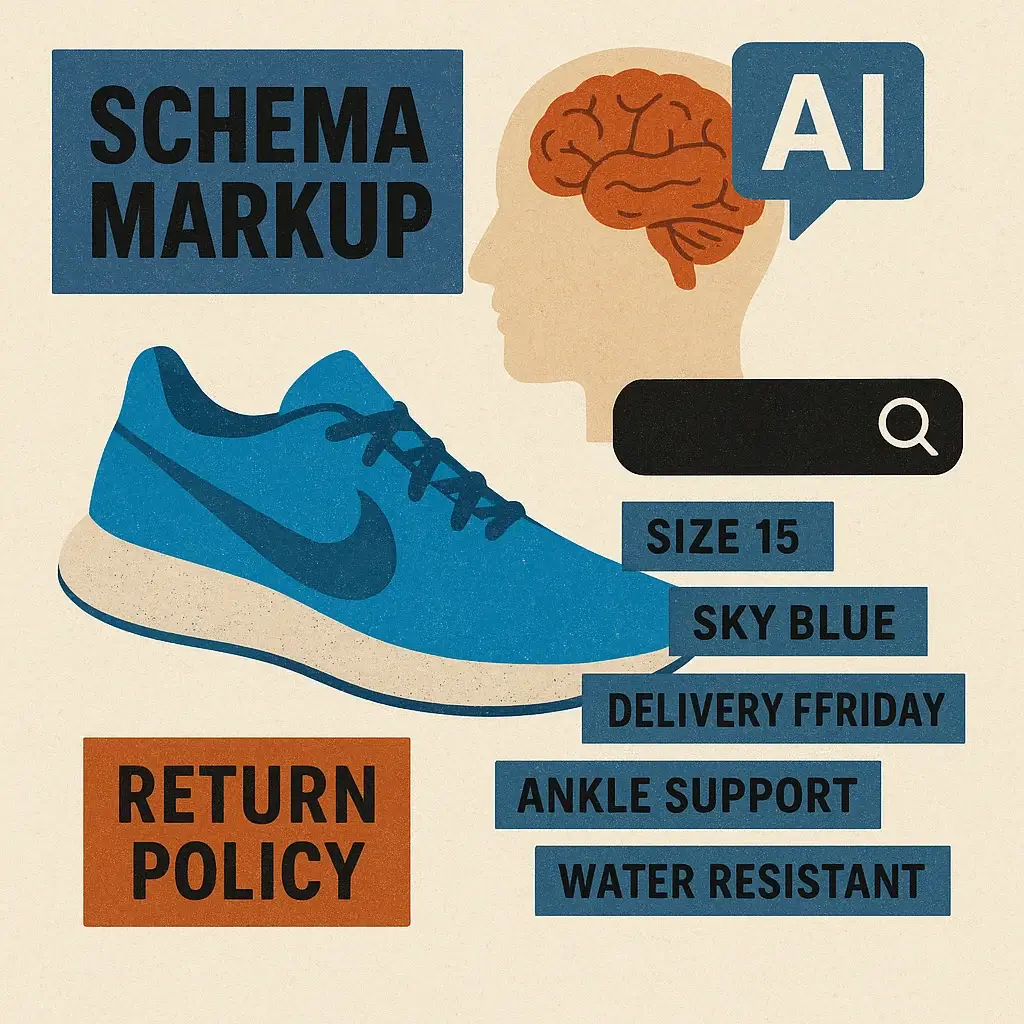
Atributos detalhados também ganham importância porque, em buscas feitas por IA, os usuários tendem a ser muito mais específicos do que em buscas tradicionais por palavras-chave. Um cliente pode não querer apenas um tênis de determinada marca, mas um modelo no tamanho 15, na cor azul-céu, com entrega até sexta-feira e conforto para quem tem problema no tornozelo. Detalhes como material, peso, resistência à água, cor, tamanho, velocidade de envio e política de devolução ajudam o buscador a conectar essas consultas específicas ao produto certo.
Schema de entidade e de autor
Adicionar uma entidade do tipo “Person” no schema não transforma ninguém em especialista automaticamente — a marcação só ajuda uma máquina a verificar uma autoridade que já existe de fato.
Um exemplo prático mostra quando isso funciona: um cliente especializado em tecnologia de jardinagem indoor lançou, três meses antes de um surto de doença transmitida por alimentos, uma campanha de conteúdo sobre recall de alimentos, destacando que cultivar a própria comida pode ajudar a evitar exposição a produtos contaminados. Quando as buscas por recalls dispararam durante um fim de semana, o post de março sobre recall de alface e segurança alimentar apareceu no topo do AI Overview, ao lado de referências como FDA e CDC (agências de saúde e segurança alimentar dos EUA). O conteúdo ficou em segundo lugar na busca orgânica, atrás apenas do FDA, e gerou cerca de 1.300 cliques durante esse ciclo de notícias.
O resultado não veio de uma única propriedade de schema, mas da construção de uma presença digital sólida para a marca: credenciais do autor, artigos publicados e trabalhos anteriores estavam presentes tanto na página do autor quanto no próprio post. Quando um mecanismo de busca precisa decidir entre citar um site comercial ao lado de uma agência governamental, ele precisa de motivos concretos para não descartar essa fonte.
Outro caso envolveu uma empresa com nome genérico, compartilhado por diversos outros negócios — buscas pelo CEO da companhia simplesmente não retornavam resultados relacionados a ela. A solução foi criar um schema completo de pessoa na página de biografia do executivo, vinculado aos perfis e dados corretos da empresa. Em poucos dias, o AI Overview passou a identificar corretamente o profissional.
O que o schema não faz é compensar conteúdo raso, credenciais inventadas ou um perfil abandonado. Ele não transforma uma conta de rede social inativa em prova de credibilidade, nem substitui o conteúdo visível em HTML.
A recomendação final é conquistar a autoridade antes de tudo, expressá-la com clareza e garantir que ela possa ser facilmente verificada.
Validar antes de escalar
O schema traz resultados quando aplicado em larga escala, mas expandir a implementação antes de validar o modelo apenas multiplica os mesmos erros por milhares de páginas. Por isso, a orientação é começar com uma única página, tratando-a como modelo de referência antes de replicar a estratégia para o restante do site.
Com informações de searchenginejournal.com.