



Quem cuida de site e vive com medo de sumir do Google agora pode respirar um pouco mais aliviado. No dia 15 de setembro, a Cloudflare lançou uma configuração que permite aos donos de sites recusarem o uso de seu conteúdo para treinar modelos de inteligência artificial sem, no entanto, bloquear os rastreadores do Google, do Bing e da Apple — justamente aqueles que colocam as páginas nos resultados de busca. O recurso se chama Disallow AI Training e está disponível em todos os planos, incluindo o gratuito, o que é uma boa notícia pra quem administra portais menores. Esse ajuste no bloqueio IA Cloudflare chega como resposta a um impasse que vinha incomodando muita gente no setor.
Até então, Googlebot, Bingbot e Applebot faziam dois trabalhos ao mesmo tempo: indexavam páginas para a busca e também coletavam conteúdo que podia alimentar modelos de IA. Ou seja, se um site bloqueasse qualquer um desses rastreadores, perdia também sua posição nos resultados de pesquisa — um preço alto demais pra quem só queria proteger seu conteúdo do treinamento de IA. Segundo a Cloudflare, menos de 1% dos sites da sua rede bloqueiam bots de busca, enquanto 17% já ativaram algum tipo de bloqueio para treinamento.
Como funciona o bloqueio IA Cloudflare na prática
Em julho, a Cloudflare já havia avisado que, a partir de 15 de setembro, qualquer site que bloqueasse o treinamento de IA acabaria bloqueando também esses três rastreadores importantes. Desde então, a empresa negociou com Google, Microsoft e Apple, e cada uma dessas companhias adicionou — ou prometeu adicionar até uma data definida — uma opção de recusa específica para treinamento.
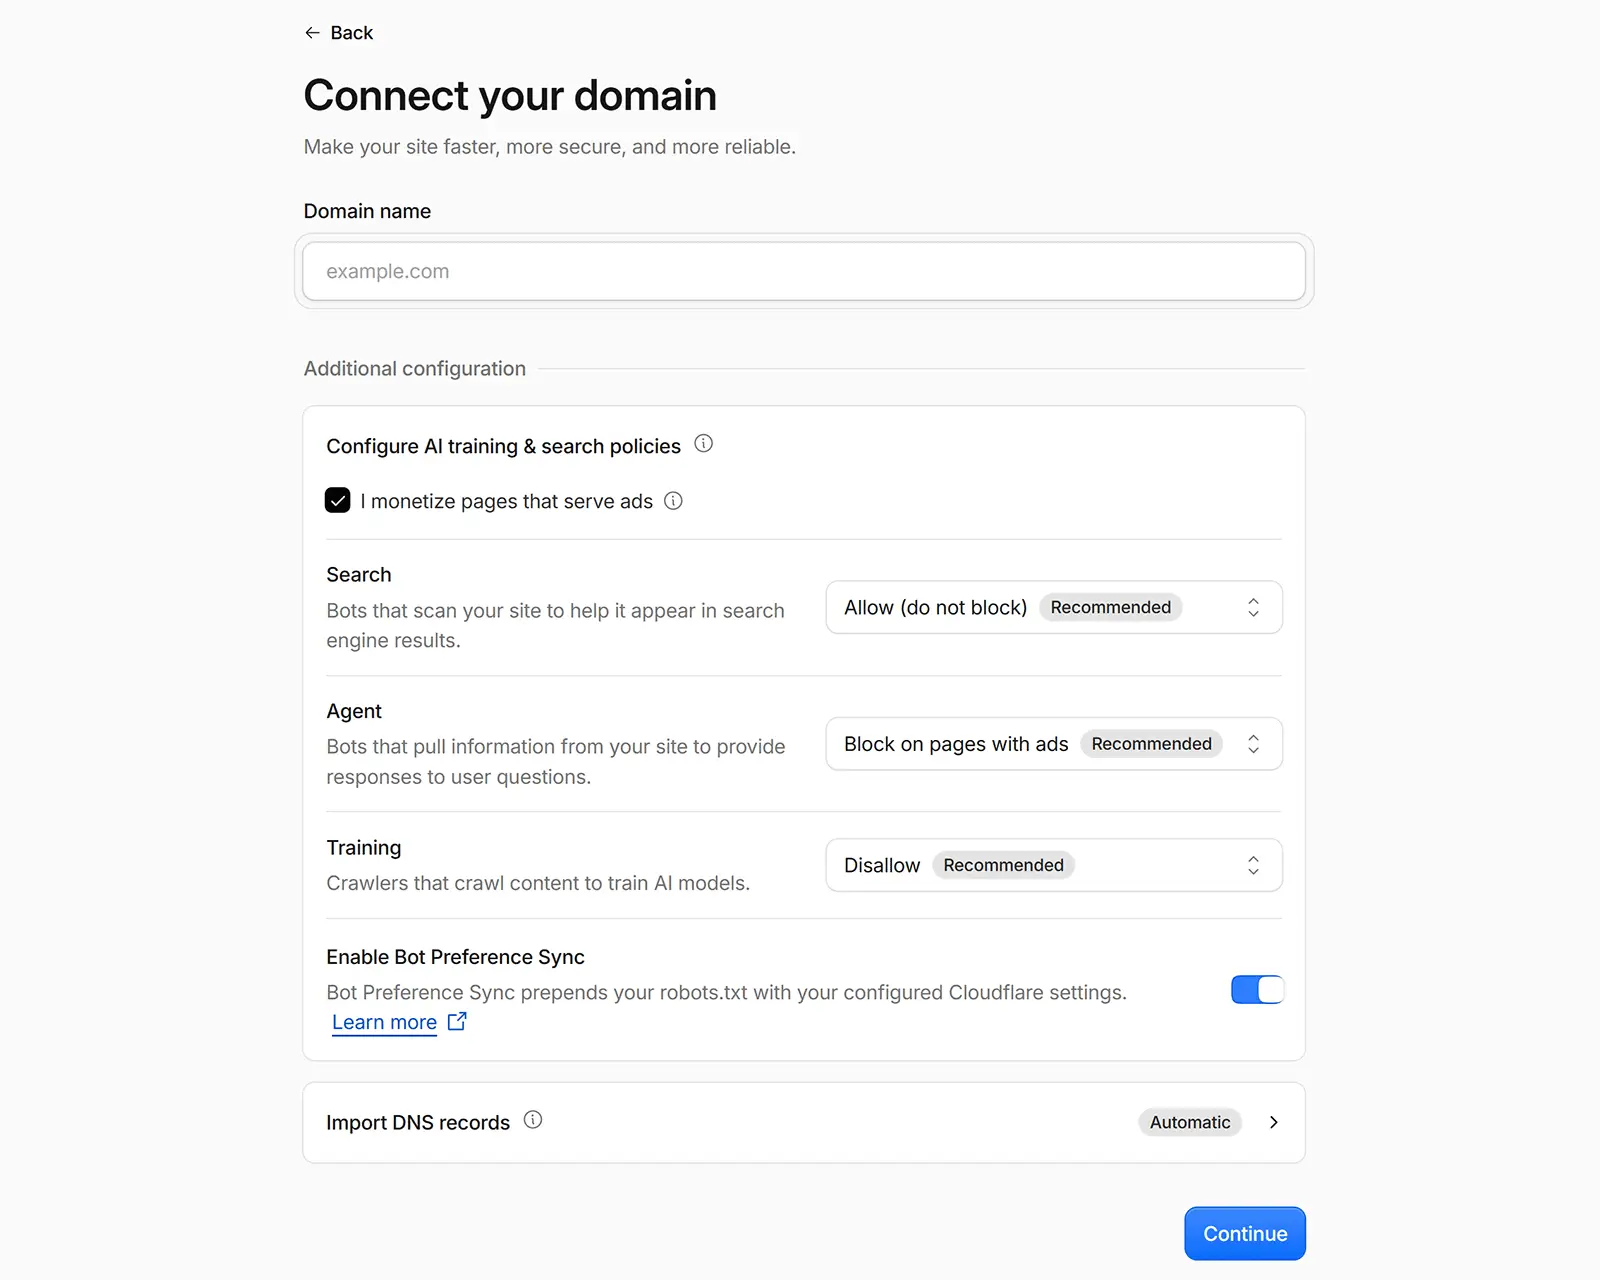
Quando o site owner ativa a configuração, o sistema de Bot Preference Sync da Cloudflare insere duas regras no arquivo robots.txt: uma desautorizando o Google-Extended e outra bloqueando o Applebot-Extended. Esses tokens são usados pelo Google e pela Apple exclusivamente para treinamento de IA, não para indexação de busca. Já Amazon, Anthropic, Meta e OpenAI operam rastreadores separados para treinamento e para busca, e a Cloudflare bloqueia diretamente os rastreadores de treinamento dessas empresas — enquanto isso, páginas continuam acessíveis para ferramentas como o ChatGPT search.
Googlebot, Bingbot e Applebot permanecem liberados porque a Cloudflare passou a classificar seus operadores como “Accountable” (algo como “responsáveis”), categoria concedida a quem oferece quatro garantias:
- Uma forma de o site recusar o treinamento de IA via robots.txt ou padrão equivalente
- Uma forma de recusar resumos gerados por IA
- Visibilidade em nível de URL sobre quais páginas foram disponibilizadas para treinamento
- Garantia de que recusar o treinamento não afeta o ranqueamento nas buscas
O Google afirma que seu relatório em nível de URL deve chegar nas próximas semanas, enquanto a Apple projeta isso para o ano que vem. A Microsoft está mais atrasada nesse quesito: o Bingbot só vai ler a regra do robots.txt no início de 2027, o que significa que, por enquanto, a única maneira de impedir que o Bing treine sobre uma página é adicionar uma meta tag NOARCHIVE.
O que os primeiros números revelam
A SeenSure testou como 1.046 sites reagiram a oito rastreadores de IA em 14 de setembro e repetiu o teste em 16 de setembro. Desses sites, 746 usavam Cloudflare, e boa parte deles passou a recusar rastreadores de treinamento depois da mudança: as recusas ao GPTBot subiram de 18,9% para 22,0%, e as ao ClaudeBot foram de 19,9% para 22,8%.
O anúncio da Cloudflare não mencionava nenhuma alteração para rastreadores de busca de IA ou agentes, mas, curiosamente, as recusas a essas categorias caíram cerca de 13 pontos percentuais cada. O OAI-SearchBot, que alimenta o ChatGPT search, era recusado por 16,9% dos sites que usam Cloudflare antes da mudança e por apenas 3,0% depois. Já os 300 sites que não usam a Cloudflare mantiveram os números estáveis. Se esse padrão se confirmar, o ChatGPT search e o Perplexity passam a conseguir ler muitas páginas hospedadas na Cloudflare que antes estavam fechadas para eles.
“A busca foi a categoria que mais se movimentou”, escreveu a consultora de SEO Aleyda Solis no X ao compartilhar os resultados.
Recusar treinamento não tira seu site das respostas de IA
É importante entender que essa nova configuração só decide se o conteúdo pode ser usado para treinar modelos — ela não determina se o site vai aparecer nas respostas geradas por IA. Isso deixa os donos de sites com três decisões separadas pela frente: indexação de busca, treinamento de IA e aparição em respostas de IA, sendo que o ajuste da Cloudflare cobre apenas o treinamento. A empresa já sinalizou que os resumos de IA são o próximo item da lista, com controles próprios previstos para o ano que vem.
Desativar o treinamento não é, porém, a escolha óbvia para todo mundo. Para sites que não rodam anúncios, a recomendação padrão da Cloudflare é manter o treinamento liberado. Afinal, uma marca que quer ser conhecida e mencionada pelas ferramentas de IA pode se beneficiar de estar nos dados de treinamento — embora nenhuma empresa de IA tenha detalhado o quanto isso realmente pesa. Por outro lado, a Cloudflare recomenda ativar o Disallow AI Training justamente para publishers que vivem de anúncios em seu conteúdo.
Vale lembrar que uma regra no robots.txt é apenas um pedido, e um rastreador pode simplesmente ignorá-la. A Cloudflare consegue detectar e bloquear quem não respeita essa regra, mas, no caso de Google, Apple e Microsoft, está confiando em compromissos firmados com uma empresa que vende produtos de bloqueio de bots e que também escreveu o próprio padrão “Accountable”. A Cloudflare promete acompanhar publicamente esse progresso pelo Cloudflare Radar.
Como acompanhar essas configurações na prática
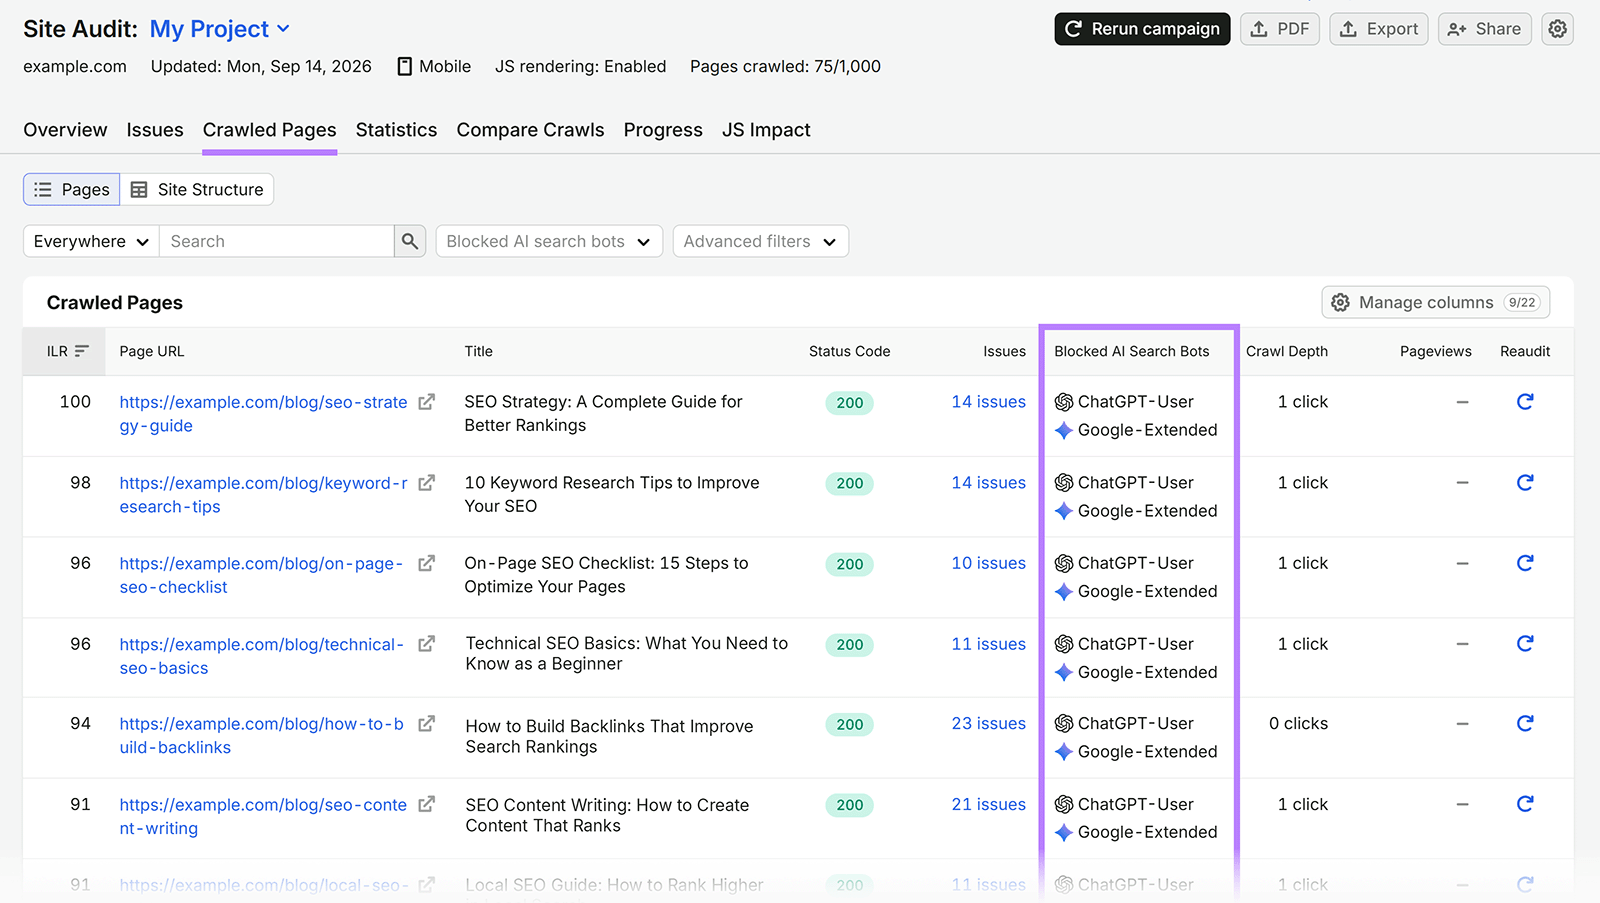
A verificação Blocked from AI Search, do Site Audit, lê o arquivo robots.txt e lista quais rastreadores de IA estão bloqueados em quais páginas. Como o Google-Extended está nessa lista, ele vai aparecer como bloqueado assim que o Disallow AI Training for ativado — mas Googlebot, OAI-SearchBot e os demais rastreadores de busca não devem aparecer como bloqueados.
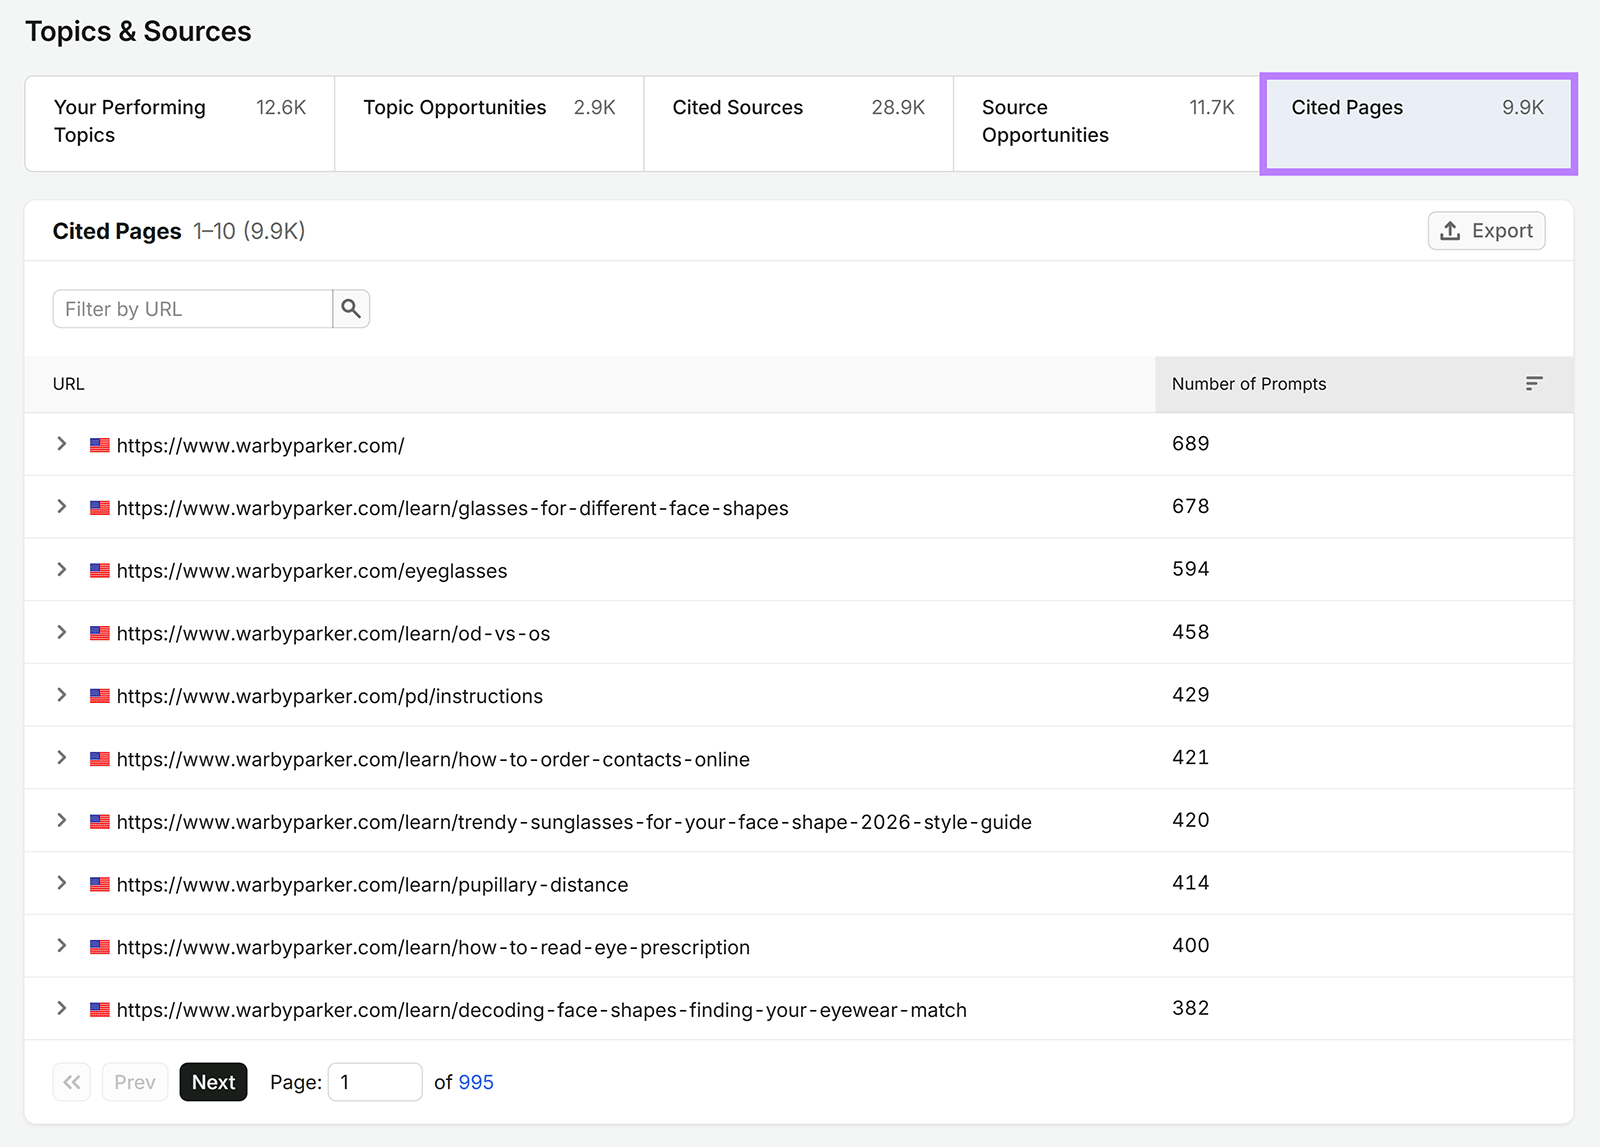
Essa ferramenta, porém, lê apenas o robots.txt e não detecta bloqueios feitos diretamente no firewall da Cloudflare. Por isso, vale checar os logs do servidor para confirmar que os rastreadores de busca desejados continuam recebendo códigos de status 200. Já o AI Visibility Toolkit mostra se essas mudanças afetam a frequência com que a marca aparece em respostas de IA, rastreando páginas e menções no ChatGPT, Google AI Mode, AI Overviews e Gemini — a aba Cited Pages, dentro de Visibility Overview, lista quais URLs são citadas e por quantos prompts. Plustag IA recomenda registrar esses números antes de qualquer mudança na configuração e comparar o resultado algumas semanas depois, pra ter uma visão clara do impacto real dessa decisão.
Com informações de semrush.com.