

A forma como sites lidam com robôs de inteligência artificial precisa mudar. Durante anos, bastava escolher entre permitir ou bloquear o acesso de rastreadores. Hoje, essa lógica binária já não dá conta da variedade de bots que circulam pela web e pode fazer empresas perderem visibilidade justamente nas respostas geradas por IA.
O alerta parte de Chris Green, em artigo publicado originalmente no site AI Search Marketing. Segundo ele, a popularização da busca por IA tornou o modelo antigo de controle de acesso insuficiente para proteger a presença das marcas na internet.
Por que a gestão de bots de IA ficou mais complexa?
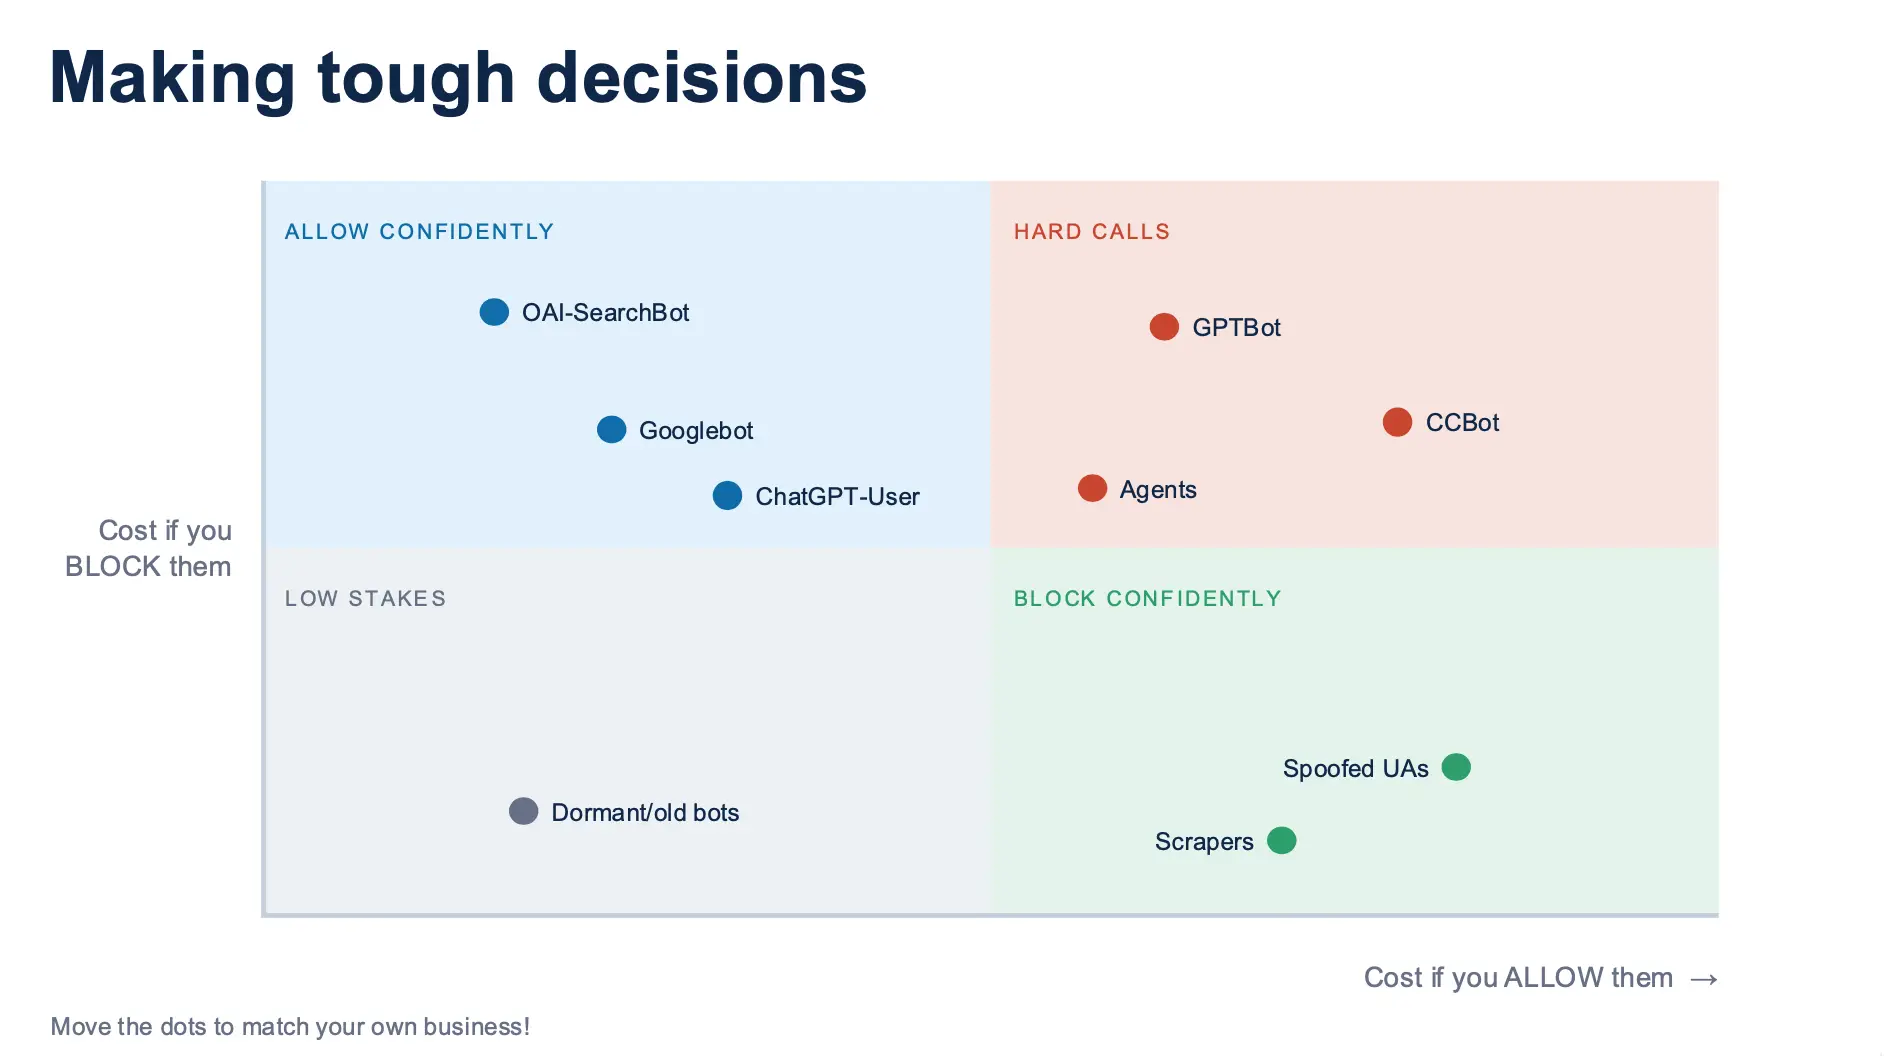
Green explica que, atualmente, um mesmo site recebe visitas de crawlers tradicionais de busca, rastreadores usados para treinar modelos de IA, bots de recuperação de conteúdo, buscas feitas diretamente por usuários e até agentes autônomos. Apesar dessas diferenças, todos costumam ser tratados genericamente como “bots de IA”.
Essa generalização é um problema, segundo o autor. Bloquear um rastreador que alimenta o treinamento de um modelo tem consequências bem diferentes de bloquear um bot que busca informações para montar uma resposta em tempo real para o usuário.
Qual o risco para quem bloqueia o bot errado?
O principal risco apontado por Green é o desaparecimento completo de respostas de IA, não apenas uma queda de posição no ranking. Ele cita o exemplo de um agente autônomo que realiza uma comparação de produtos em nome de um usuário: se esse agente for bloqueado, a marca pode simplesmente sumir da resposta final entregue à pessoa.
Isso acontece porque agentes de IA navegam pelos sites de forma parecida com usuários humanos. Eles acionam ferramentas de analytics e são cada vez mais difíceis de diferenciar de uma visita real, o que torna a decisão de bloquear ou liberar ainda mais delicada.
O robots.txt ainda funciona?
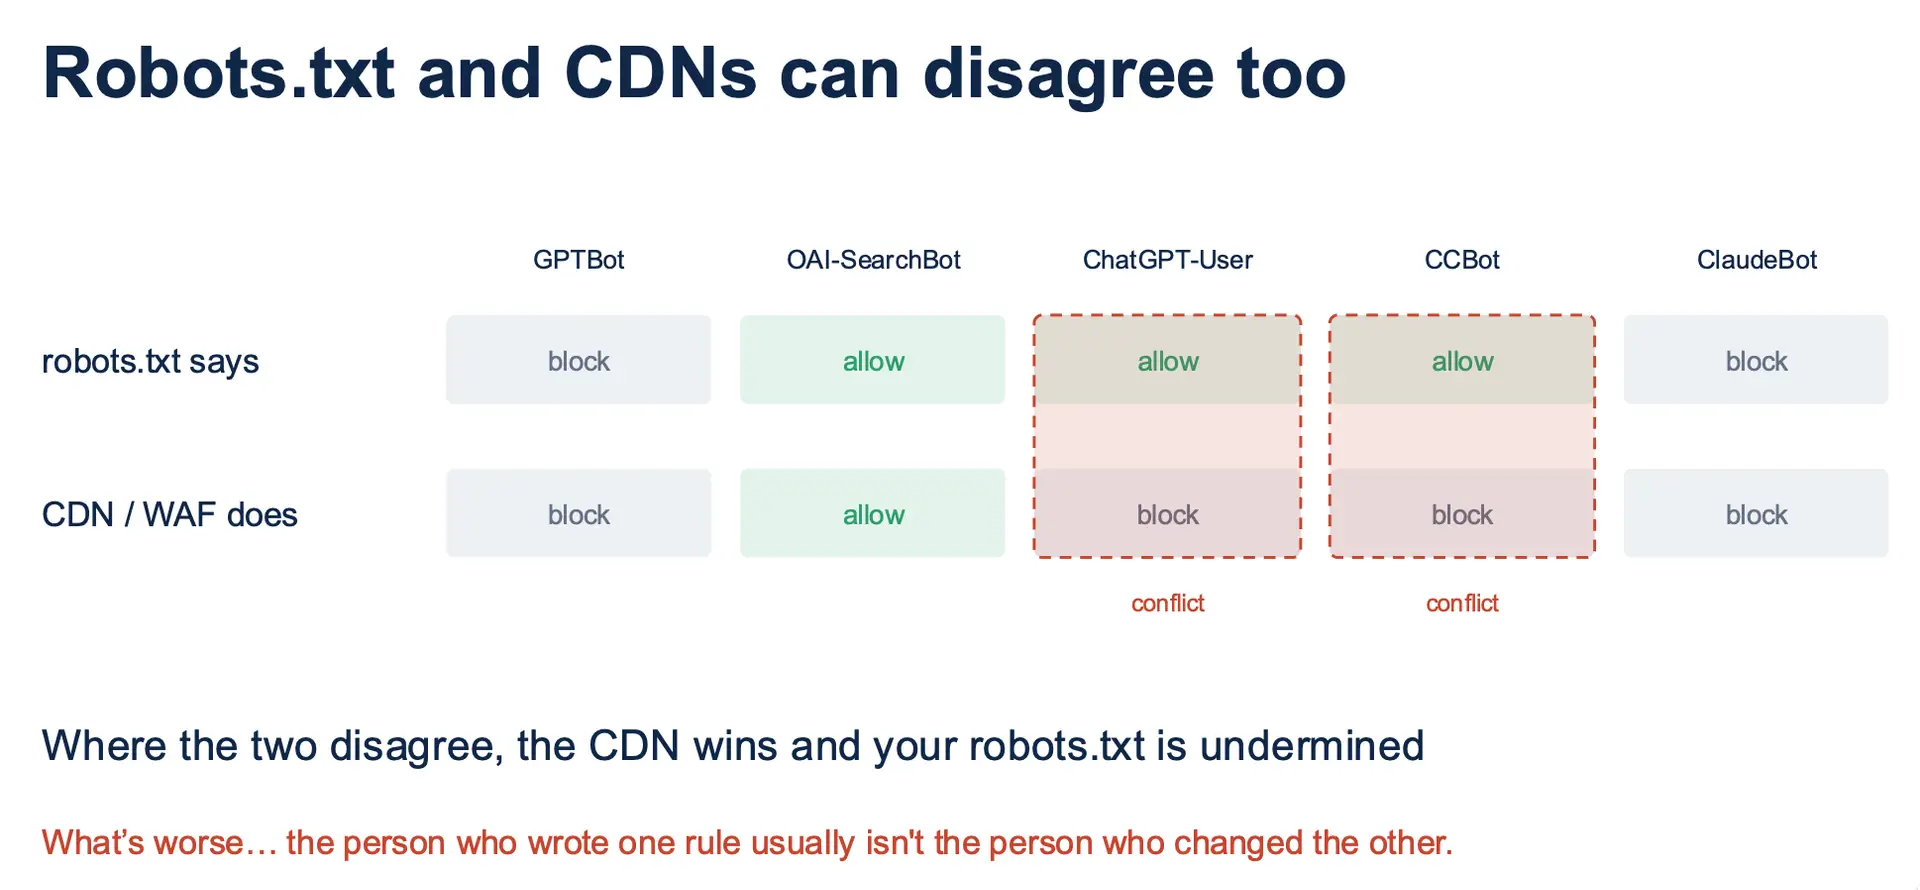
De acordo com o autor, o arquivo robots.txt continua tendo utilidade, mas seu cumprimento depende da boa vontade de cada rastreador, já que se trata de uma regra voluntária. Na prática, quem realmente aplica as restrições de acesso são CDNs, firewalls de aplicação web (WAFs) e serviços de mitigação de bots.
Green chama atenção para um ponto delicado: essas ferramentas podem entrar em contradição com as regras definidas no robots.txt, e isso pode acontecer sem que a equipe de SEO sequer perceba. Ou seja, a estratégia de visibilidade pode estar sendo sabotada por configurações técnicas tomadas em outra área da empresa.
O que o autor propõe no lugar das listas de bloqueio?
Green defende que empresas abandonem listas simples de bloqueio e adotem políticas de bots mais elaboradas. Essas políticas devem levar em conta quem está acessando o conteúdo, qual o motivo do acesso e quais as consequências de permitir ou negar essa entrada.
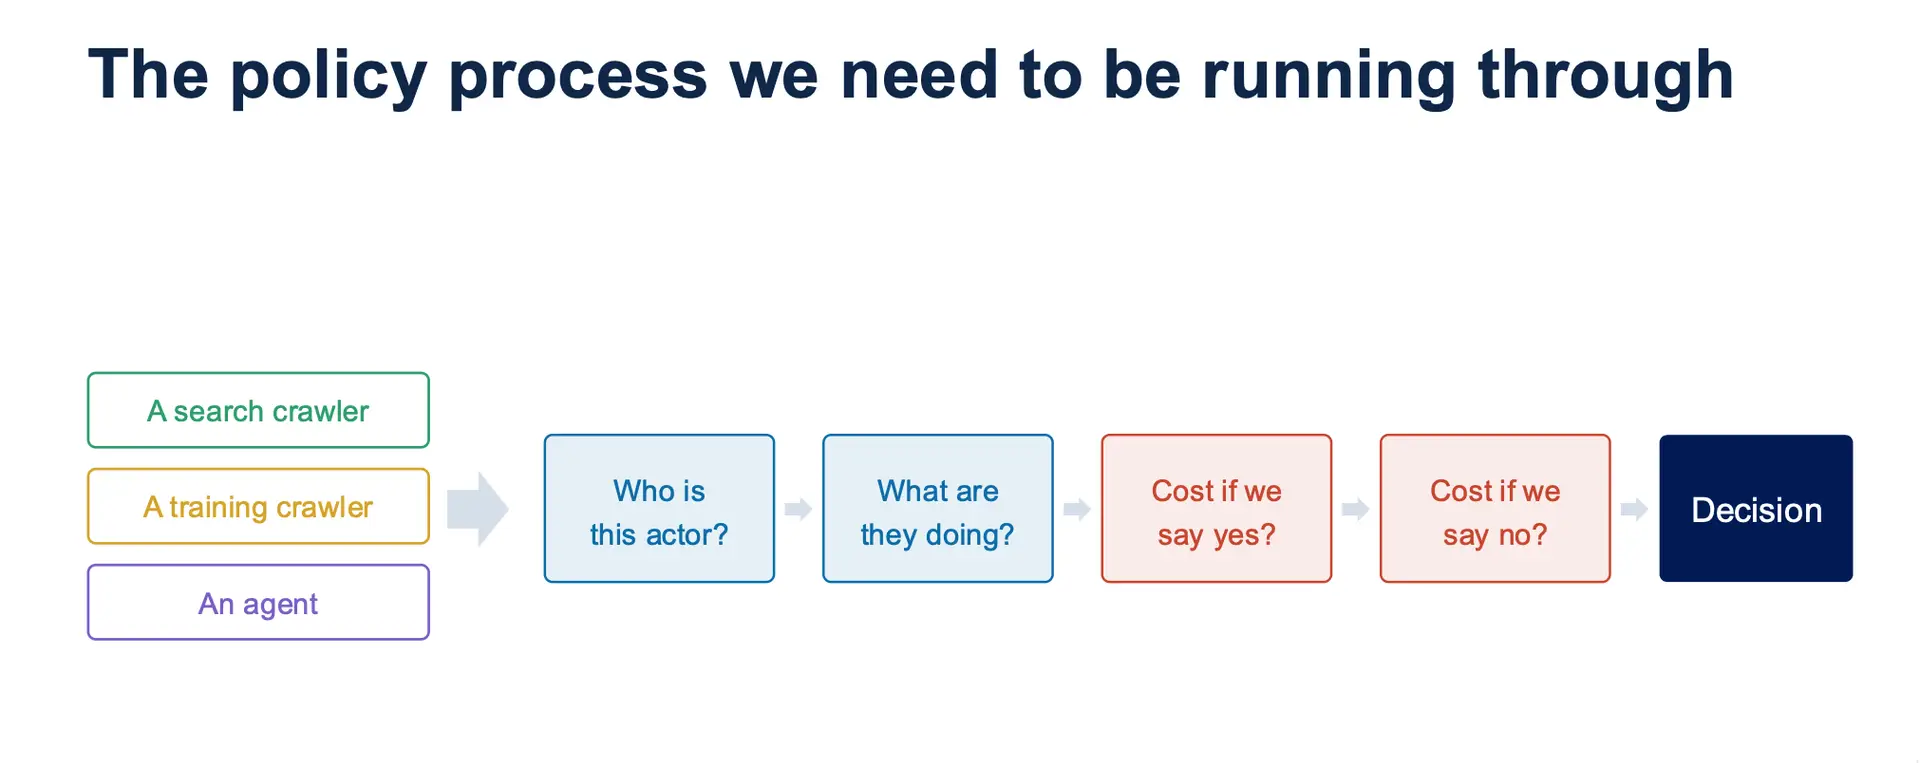
Segundo ele, essas decisões não cabem mais apenas ao time de SEO. Elas precisam envolver também as áreas de engenharia, segurança, jurídico e comercial, de forma coordenada. Green ressalta ainda que as regras definidas precisam ser aplicadas de maneira consistente e revisadas com regularidade, já que o cenário de bots e agentes de IA muda rapidamente.
Próximos passos para quem cuida de SEO
A recomendação prática deixada por Green é que as empresas mapeiem com precisão quais tipos de bot acessam seus sites e para qual finalidade, antes de decidir bloquear qualquer um deles. Sem esse diagnóstico, o risco é tomar decisões técnicas isoladas que acabam custando visibilidade justamente no momento em que a busca por IA ganha mais espaço no comportamento dos usuários.
Com informações de searchenginejournal.com.