

Depois de decidir bloquear os crawlers de inteligência artificial que rastreiam um site, surge uma dúvida técnica importante entre profissionais de SEO: qual é o método mais eficaz para essa restrição? Existem dois caminhos principais para isso — a configuração via robots.txt e o bloqueio na camada de servidor. Cada abordagem tem vantagens e limitações que merecem ser entendidas antes da implementação.
Como funciona cada método
Bloqueio via robots.txt
Restringir bots de IA pelo robots.txt segue a mesma lógica usada para qualquer outro tipo de robô. Cada agente de IA possui um nome próprio de identificação — como o GPTBot e o OAI-SearchBot, da OpenAI. Para impedir o acesso, basta inserir uma regra de “disallow” com o nome do crawler correspondente. Um exemplo para bloquear totalmente o GPTBot seria:
User-agent: GPTBot
Disallow: /
Também é possível limitar o bloqueio a áreas específicas do site. Para impedir que o GPTBot acesse apenas as páginas de produto, por exemplo, a regra ficaria assim:
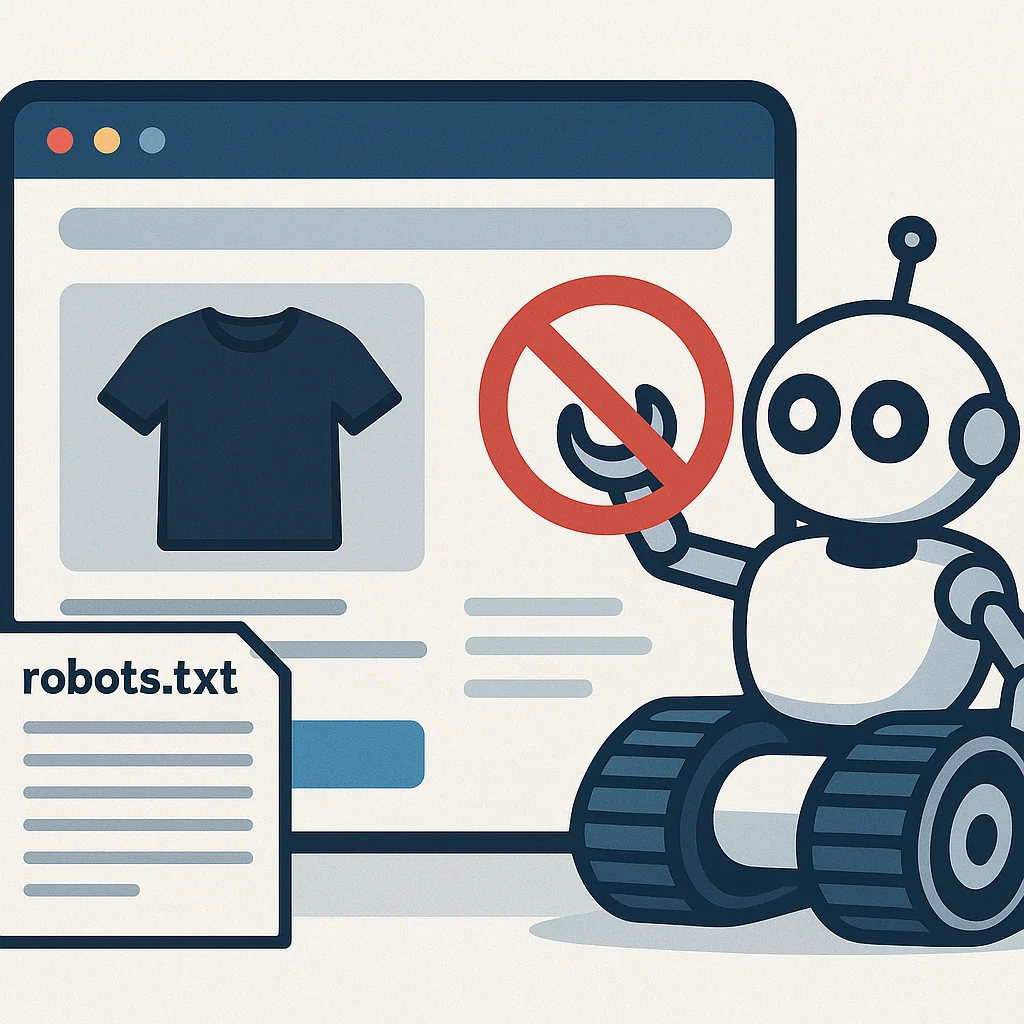
User-agent: GPTBot
Disallow: /products/
Bloqueio na camada de servidor
Nesse caso, existem três frentes possíveis: o próprio servidor, a CDN (rede de distribuição de conteúdo) ou o WAF (firewall de aplicação web).
- No servidor, a requisição do bot é analisada — considerando IP, cabeçalhos e outros dados — e regras específicas são aplicadas, como negar, permitir ou redirecionar o acesso.
- Na CDN, a lógica é semelhante, mas a interceptação ocorre antes que a requisição chegue ao servidor, economizando largura de banda. Algumas CDNs já oferecem bloqueio nativo, como o Cloudflare, que permite configurações predefinidas para classificar bots de busca, agentes ou bots usados em treinamento de IA, além de ajustes individuais por bot.
- No WAF, a análise é ainda mais rigorosa, avaliando o comportamento da requisição e não apenas os cabeçalhos informados. Isso permite identificar bots que tentam se disfarçar como outros user-agents. O WAF pode estar integrado à CDN, como no caso do Cloudflare WAF, ou funcionar como uma solução independente, como o AWS WAF.
Vantagens e desvantagens do robots.txt
O robots.txt costuma ser a opção mais acessível para profissionais de SEO, já que muitos têm permissão direta para editá-lo ou podem solicitar ajustes rápidos à equipe de desenvolvimento.
Pontos positivos
O mecanismo de disallow é reconhecido oficialmente pelas principais empresas de IA do mercado, incluindo:
- OpenAI (GPTBot e OAI-SearchBot)
- Anthropic (ClaudeBot, Claude-User e Claude-SearchBot)
- Google (Google-Extended)
- Perplexity (PerplexityBot)
Esse método também permite escolher exatamente quais páginas devem ficar fora do alcance de cada crawler, com controle detalhado por bot.
Pontos negativos
O maior risco é que o cumprimento das regras do robots.txt depende exclusivamente da boa vontade do bot — não há fiscalização central. Embora as empresas afirmem que seus robôs respeitam o arquivo, trata-se apenas de um pedido, não de um bloqueio de fato.
É como uma placa de “proibida a entrada” em um portão aberto. Nada impede fisicamente o acesso do bot, além da programação que o faz respeitar as regras do robots.txt.
Outro problema é que, quando o robots.txt pode ser editado facilmente pelo CMS do site, pessoas sem conhecimento técnico podem, por engano, bloquear mais bots do que o pretendido — inclusive todos os robôs, caso a regra abaixo seja aplicada incorretamente:
User-agent: *
Disallow: /
Além disso, o arquivo não se atualiza automaticamente quando novos agentes de IA surgem no mercado. Isso significa que alguém precisa incluir manualmente cada novo bot que se deseja bloquear.
Vantagens e desvantagens da camada de servidor
As vantagens de bloquear pelo servidor, CDN ou WAF variam conforme a implementação escolhida.
Pontos positivos
Nas soluções via CDN e WAF, as requisições dos bots são interrompidas antes mesmo de chegarem ao servidor, o que reduz o consumo de banda e os custos associados à sobrecarga.
A principal vantagem desse tipo de bloqueio, independentemente da opção escolhida, é que ele representa uma restrição definitiva:
Se o robots.txt é uma placa educada de “proibida a entrada”, os bloqueios de servidor, CDN e WAF funcionam como um cadeado no portão. Esses métodos não dependem da boa vontade do crawler: eles detectam e impedem o acesso, seja o bot compatível ou não com as regras.
Outro benefício é a geração de relatórios sobre os bots bloqueados, permitindo acompanhar quais robôs tentaram acessar o site. Esses dados podem ser úteis em discussões — inclusive de natureza jurídica — com as empresas responsáveis por esses crawlers, especialmente em casos de sites que recebem tráfego excessivo de bots indesejados.
Com informações de searchenginejournal.com.