

Toda vez que você faz uma busca no Google ou manda uma pergunta pro ChatGPT, seu navegador troca uma quantidade impressionante de informações com uma série de serviços internos — e essa conversa inteira fica exposta, de graça, na aba Network do Chrome DevTools. Basta apertar F12. Praticamente ninguém olha isso, mas quem se dedica a vasculhar essa rede de dados do Google acaba encontrando coisas bem interessantes escondidas à vista de todos.
Foi justamente garimpando esse tipo de informação que se chegou a uma falha de segurança no Google que rendeu uma recompensa de US$ 13.337 por meio de um programa de bug bounty. Os dados coletados mostraram detalhes de como o Google organiza seu ranqueamento internamente, incluindo nomes de parâmetros e até valores reais de métricas como o site_quality_score e o rq_semantic_class do próprio Google. A mesma técnica permitiu identificar, entre os primeiros a fazer isso, os diferentes conjuntos de fontes que o ChatGPT usa para montar respostas, as janelas de “frescor” que ele pede ao buscar conteúdo e indícios de que o Reddit continua sendo lido pela IA com a mesma intensidade de sempre — mesmo tendo praticamente deixado de ser citado nas respostas.
Nada disso exige um time de cientistas de dados. Exige curiosidade, um navegador e, hoje em dia, um agente de IA disposto a fazer a parte chata do trabalho. O ponto não é que mexer com dados de rede seja divertido (é, um pouco). O ponto é que saber algo que a concorrência não sabe é a vantagem mais sustentável que existe em SEO, e esse é um dos últimos lugares em que esse tipo de informação ainda está disponível de graça.
Por que alguém faria isso consigo mesmo
“Por quê?” é uma pergunta justa, que provavelmente boa parte dos profissionais de SEO faz pro espelho do banheiro todas as manhãs. Quem gosta de jogos, principalmente videogames, entende bem essa sensação de topar um novo desafio só pra descobrir como vencer — e é mais ou menos essa a motivação por trás dessa investigação.
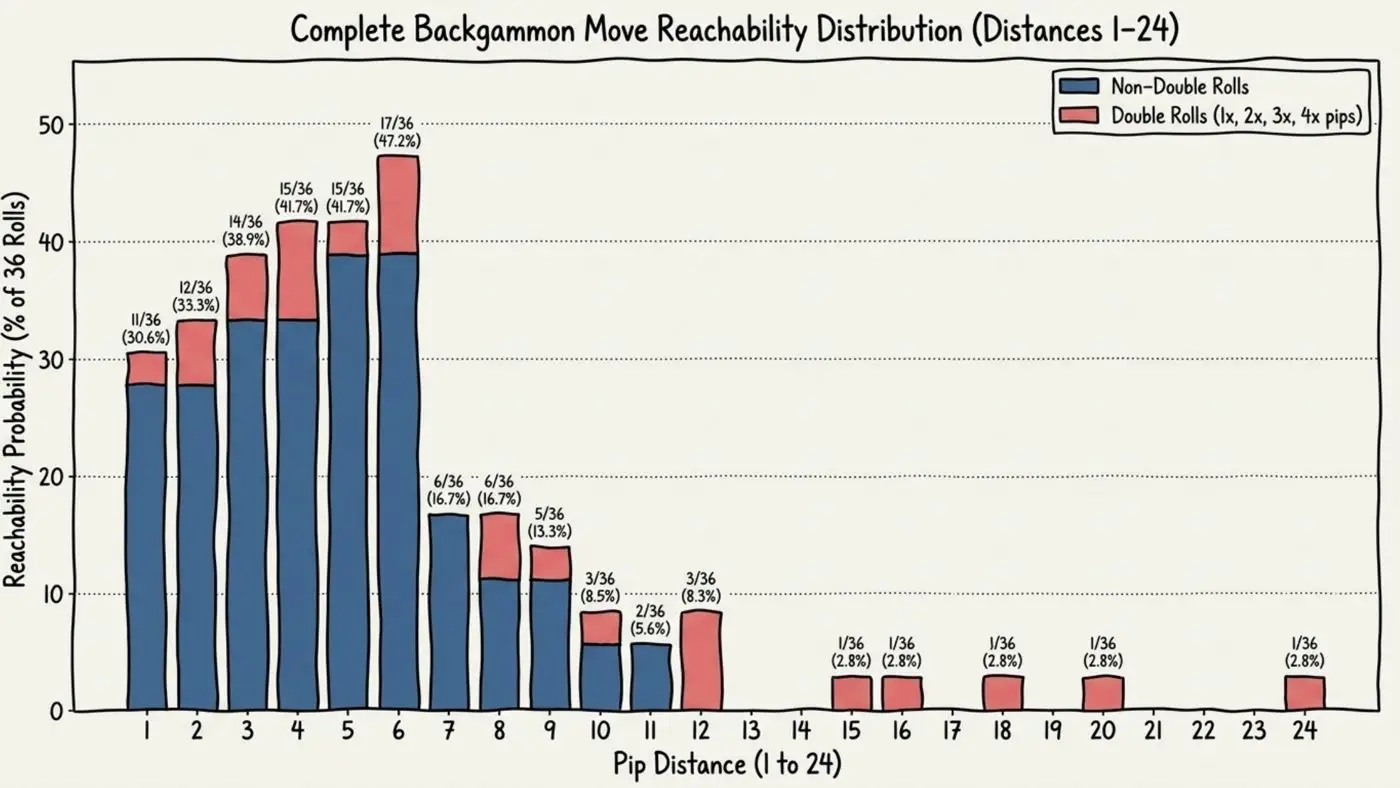
Um bom paralelo é o gamão. Como em qualquer jogo novo, primeiro você aprende as regras e depois perde repetidamente — afinal, conhecer as regras não é a mesma coisa que saber jogar bem. Foram cerca de 20 ou 30 derrotas seguidas (segundo alguns, 50 — o número é controverso). Em algum momento dessa sequência de humilhações, ao invés de simplesmente aproveitar um jogo de tabuleiro como uma pessoa normal, surgiu a ideia de buscar pequenas vantagens: por exemplo, calcular quais distâncias no tabuleiro são realmente alcançáveis com dois dados e qual a probabilidade de cada uma. Isso importa porque indica onde bloquear o adversário e onde é seguro deixar uma peça exposta.
O SEO funciona de forma parecida. Dá pra decorar todo guia de boas práticas que existe e, mesmo assim, continuar sendo mediano nisso até ganhar experiência de verdade e aprender a jogar o jogo. Afinal, otimização é a soma de pequenos ganhos acumulados ao longo do tempo — esse tipo de conhecimento permite empilhar vantagens de 1% sobre a concorrência de um jeito que ninguém consegue copiar em dez minutos, como fariam com uma lista pronta qualquer.
A analogia de pedra, papel e tesoura
Existe uma analogia bastante didática pra explicar essa lógica pra clientes ou gestores, usando o jogo de pedra, papel e tesoura. Imagine o seguinte cenário:
Você está disputando rodadas infinitas contra alguém que declarou abertamente que vai jogar sempre pedra. Qual é a forma ideal de jogar contra essa pessoa?
A resposta mais comum é “jogar sempre papel” — e está errada. Você até vence as primeiras cinco ou dez rodadas, mas seu adversário, que não é um vegetal, percebe que está perdendo sempre e muda de estratégia. Isso elimina qualquer vantagem e deixa tudo empatado de novo.
A abordagem ideal é jogar de forma aleatória, mas escolher papel só um pouquinho mais vezes. Essa “otimização” dificilmente é percebida pelo adversário e, sem motivo aparente pra mudar de tática, você vai construindo uma vantagem crescente em silêncio, com o tempo.
Blackhat vs. whitehat: o valor esperado (EV)
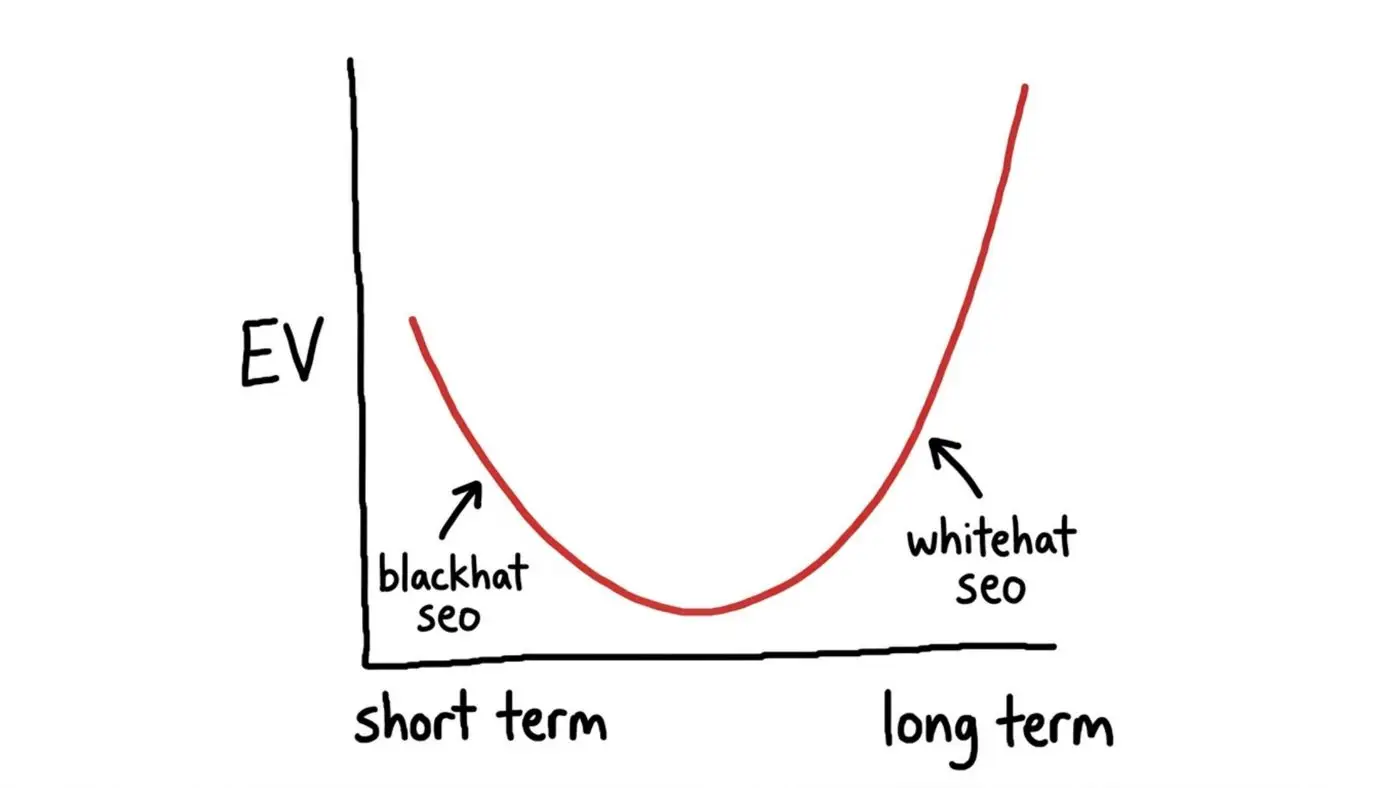
Essa analogia resume bem o embate entre SEO blackhat e whitehat. O blackhat funciona, sim, e pode gerar muito dinheiro — no exemplo acima, seria a estratégia de “jogar sempre papel”. É eficiente e o valor esperado no curto prazo é alto, mas obriga o outro lado (Google, ChatGPT, quem for) a mudar as regras do jogo, e aí a vantagem evapora — e às vezes leva o domínio junto.
Já o whitehat é o “jogar papel só um pouco mais”: gera valor real sem forçar ninguém a mudar as regras, e esse valor vai se acumulando aos poucos. É exatamente nesse ponto que os dados de rede entram como uma das melhores fontes de vantagem competitiva disponíveis hoje.
O que é, de fato, esse tal de dado de rede
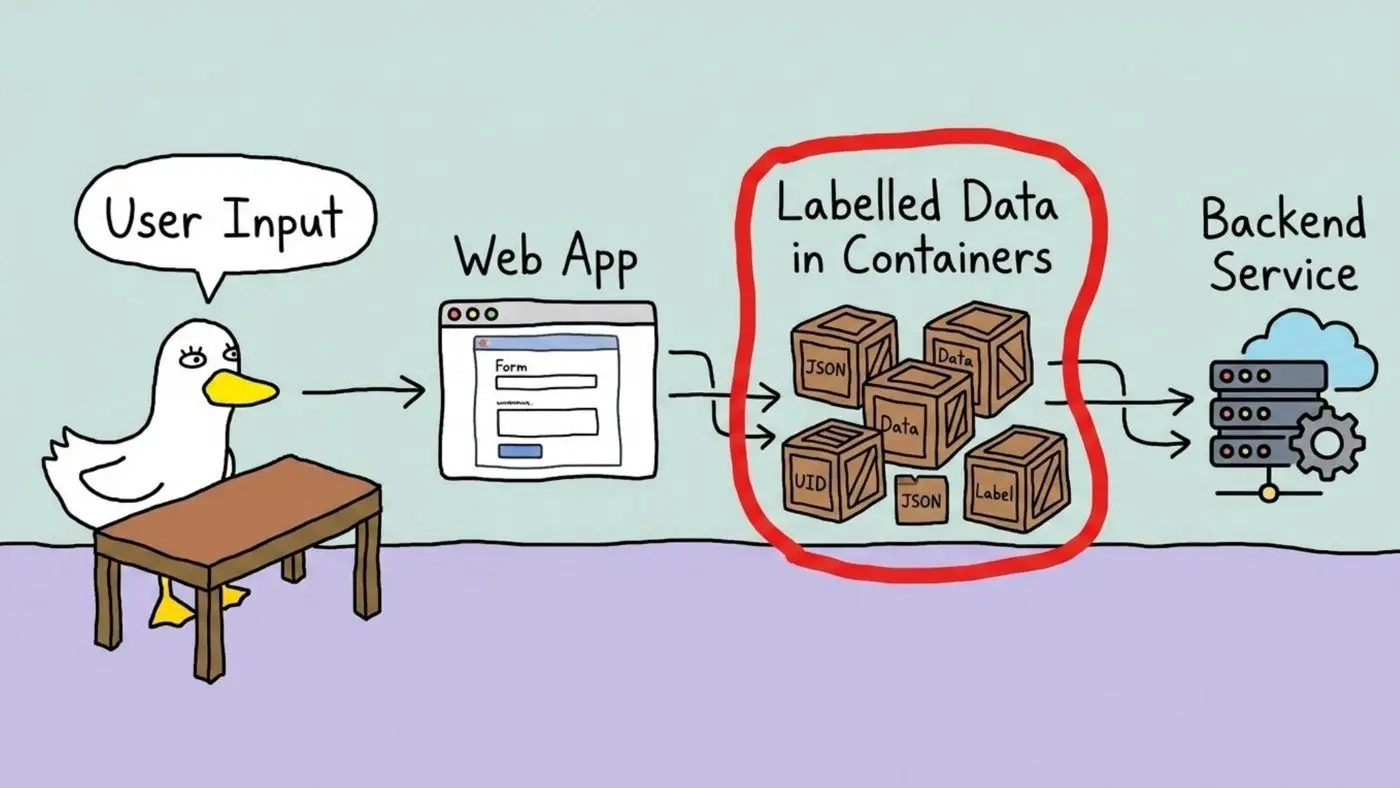
Quando você usa um aplicativo web como o Google ou o ChatGPT, o navegador envia e recebe informações de serviços de backend o tempo todo. Pensando de forma simples, é como caixotes indo e voltando de um depósito: alguns vêm com etiquetas claras, outros com etiquetas que não fazem sentido nenhum, e outros você simplesmente abre, olha o conteúdo e deduz o que está acontecendo.
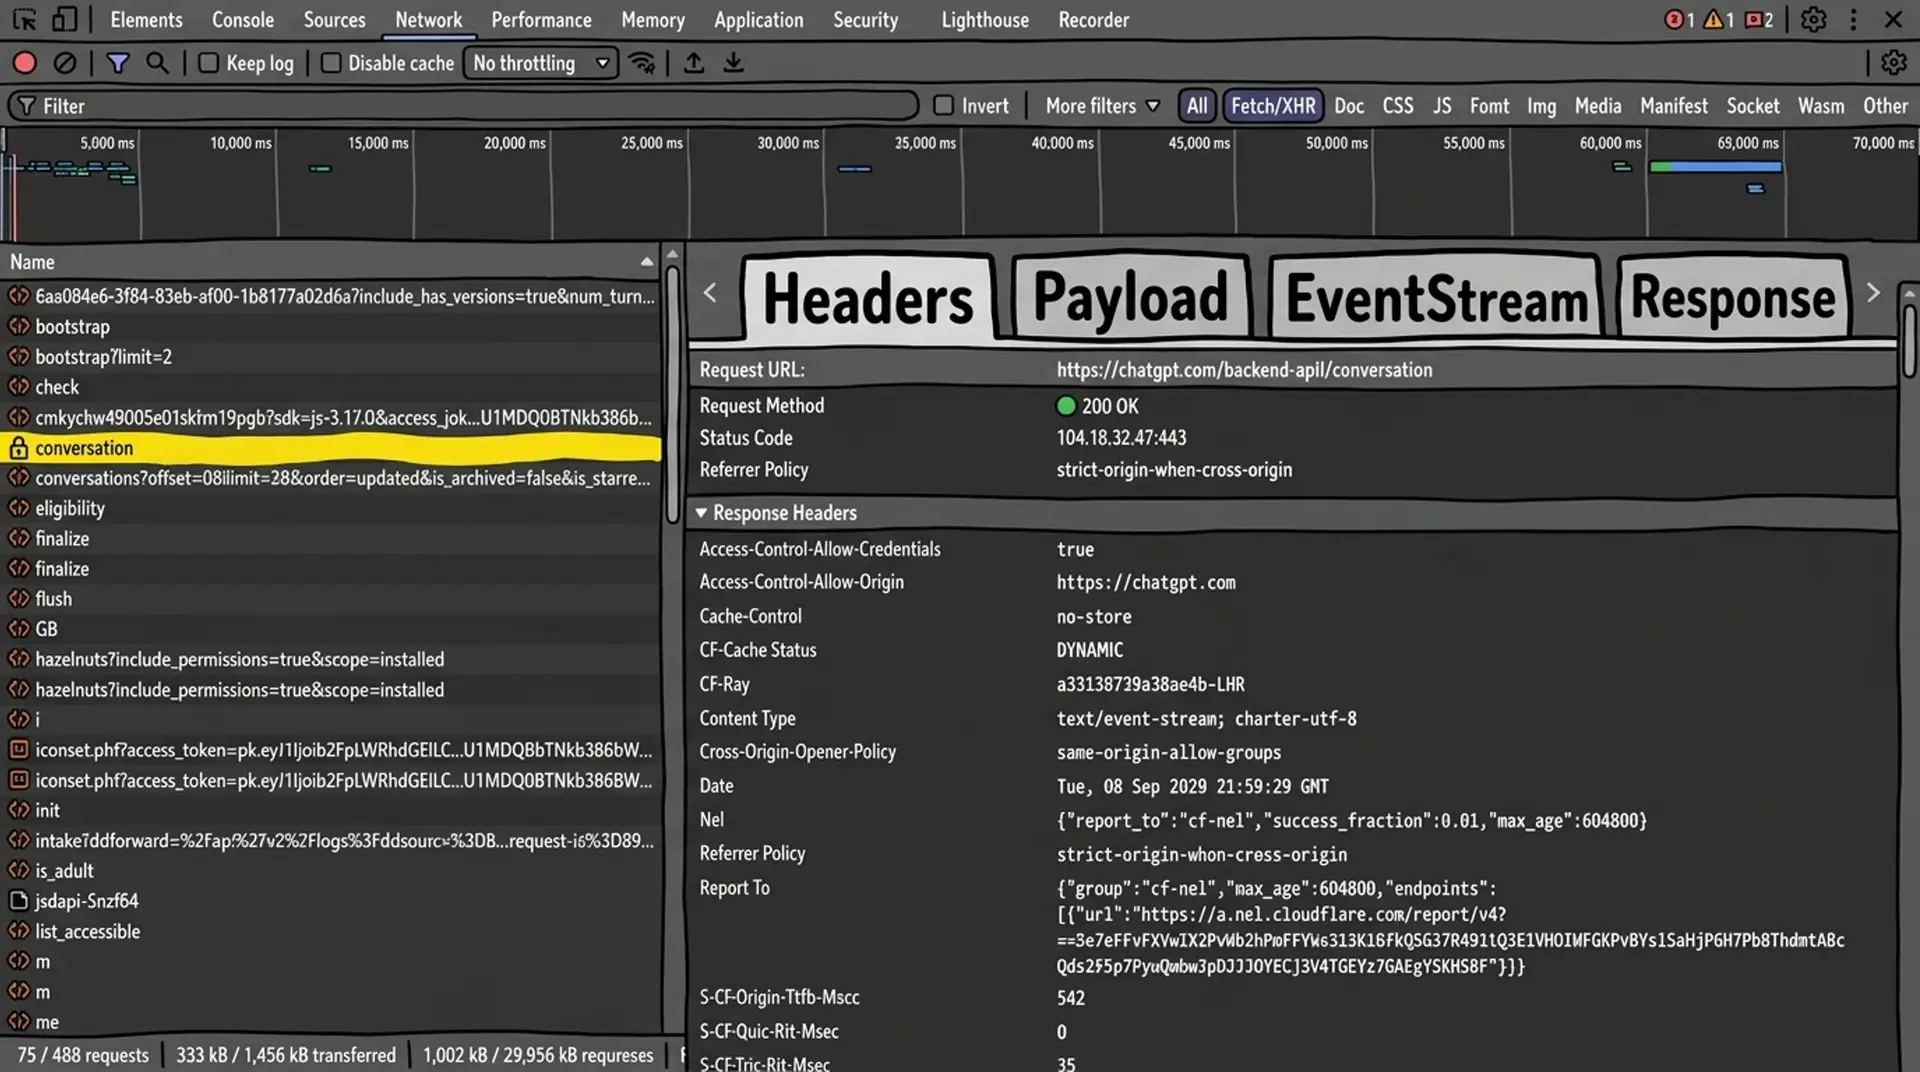
Chegar até esses “caixotes” não é complicado. Aperte F12, faça uma busca no Google ou uma pergunta no ChatGPT e, na prática, você já está dentro da Matrix. Clique na aba Network, filtre por Fetch/XHR e surge uma lista de requisições. Ao clicar em qualquer uma delas, aparecem algumas abas que parecem assustadoras, mas não são:
- Headers: instruções e metadados sobre a requisição.
- Payload: o que foi enviado.
- EventStream: o que continua chegando ao vivo, enquanto os dados vão e voltam entre navegador e backend (o ChatGPT usa muito isso enquanto gera uma resposta).
- Response: o que voltou como resposta.
Isso é interessante, e não apenas nerd, por causa de como esses sistemas são construídos. O diagrama de Mario Fischer sobre a arquitetura de ranqueamento do Google, montado a partir da documentação vazada do Content Warehouse e de documentos do processo judicial do DOJ, mostra bem isso: o que de fora parece um motor de busca único e monolítico é, na verdade, um emaranhado de pequenos subsistemas conversando entre si.
Sistemas de front-end, como o Superroot do Google, precisam saber o que foi pesquisado e puxam escores e sinais gerados em outras partes da engrenagem. Esses sinais precisam viajar por algum caminho — às vezes passam pelo próprio navegador do usuário, e nem sempre alguém se lembra de tirar as etiquetas antes.
Como a falha no Google foi descoberta, na prática
Vale uma confissão: grande parte desse tempo analisando dados de rede do Google vem do trabalho com o AlsoAsked, ferramenta que lida bastante com os dados de “As pessoas também perguntam” do Google — o que talvez explique (só um pouco) tanto tempo gasto encarando requisições.
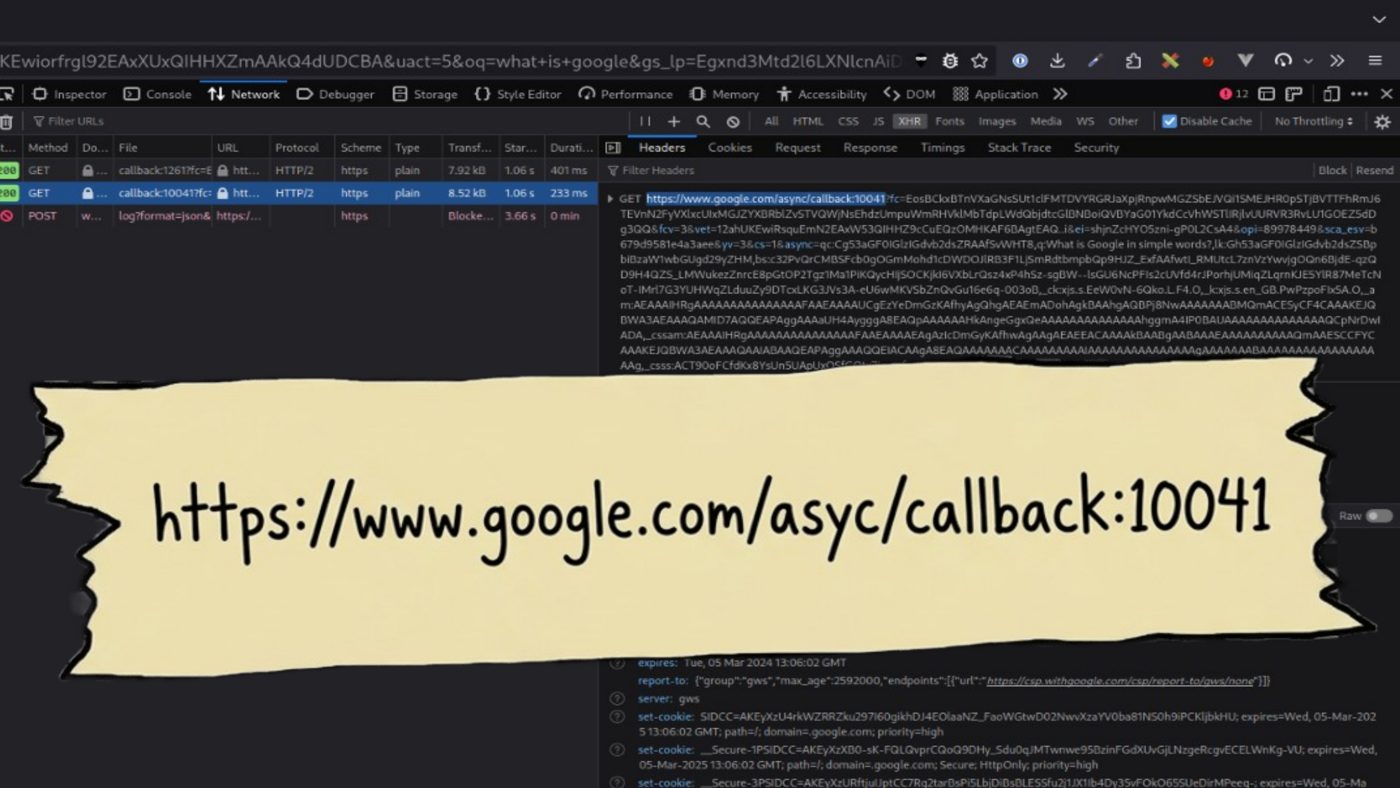
Durante essa garimpagem nos cabeçalhos de requisição, apareceu uma URL de callback com uma string de parâmetros enorme e bastante curiosa. O primeiro instinto, claro, foi copiar a requisição pro terminal, disparar com curl e ver o que o Google devolvia. (Como brincadeira, essa também seria uma ótima primeira atividade num encontro do Tinder — resultados podem variar.) A resposta trouxe bastante informação, mas que, a princípio, não fazia muito sentido.
Um dos parâmetros chamava atenção: o _fmt, configurado como prog. A hipótese, sem muita base além da intuição, era de que esse campo guardava pistas sobre o formato de resposta que o Google estava preparando para aquele pedido específico — mais um fragmento do quebra-cabeça que mostra como, por trás de uma busca aparentemente simples, existe uma rede inteira de sinais trafegando em segundo plano, prontos para quem tiver paciência de abrir o caixote e olhar dentro.
Com informações de searchenginejournal.com.