Plataformas de inteligência artificial como ChatGPT e os AI Overviews do Google dependem de robôs de rastreamento para descobrir o conteúdo que acabam citando nas respostas. O problema é que páginas carregadas em JavaScript, menus complicados e anos de conteúdo acumulado dificultam a vida desses robôs — e, se o rastreador não encontra sua página, ela simplesmente não aparece nas respostas geradas por IA. É justamente nesse cenário que entra o llms.txt, um arquivo pensado para servir como um mapa direto até o que realmente importa no seu site.
Afinal, o que é o llms.txt?
O llms.txt é um padrão proposto para ajudar os grandes modelos de linguagem (os famosos LLMs) a entenderem melhor o conteúdo de um site e usá-lo de forma mais eficiente. A lógica por trás dele é simples: em vez de deixar o robô de IA perambulando por todas as páginas, você entrega uma lista curada com o que há de mais relevante. Esse arquivo funciona, então, como um guia de prioridades — dizendo à IA exatamente para onde olhar.
Já existem padrões consagrados, como o robots.txt e os sitemaps, que ajudam motores de busca tradicionais a navegar pelos sites. A diferença é que o llms.txt nasceu especificamente pensando em modelos de IA que usam esse conteúdo para gerar respostas aos usuários.
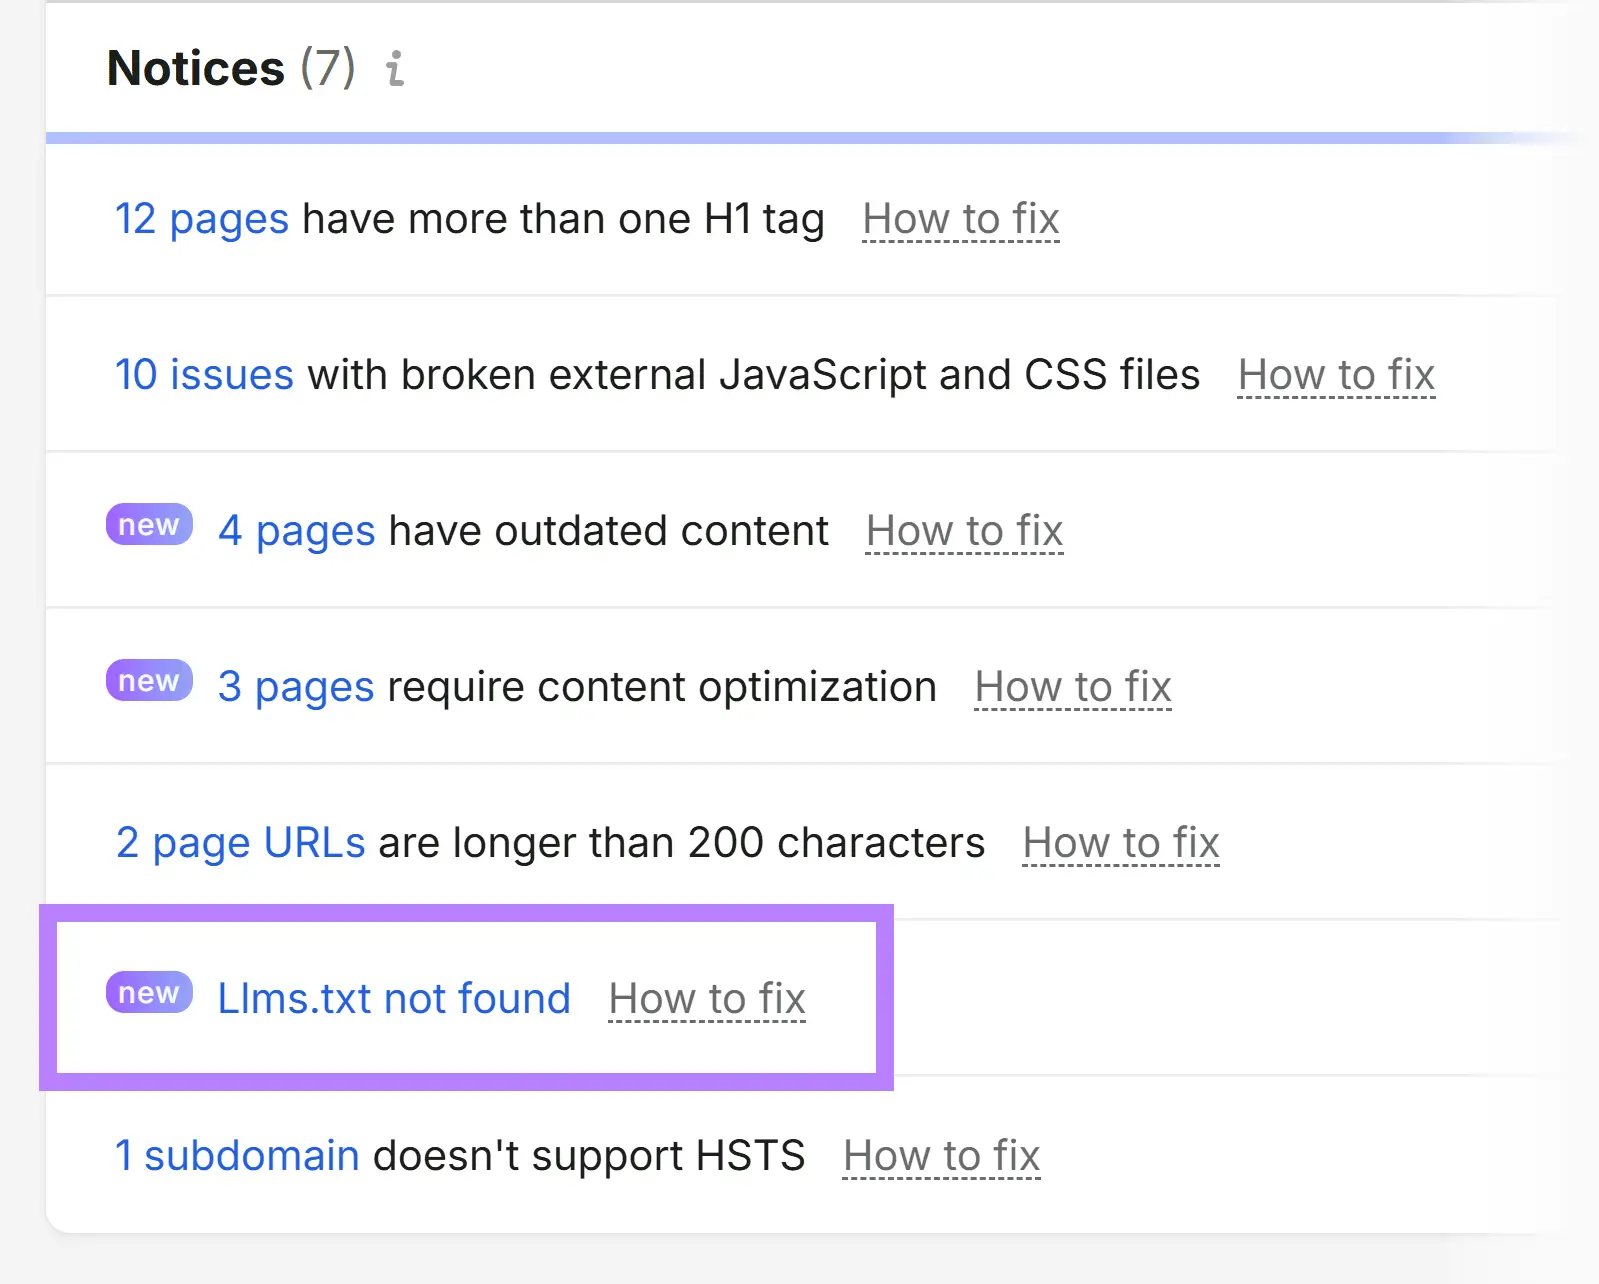
Há quem especule que adotar o llms.txt pode aumentar a visibilidade em respostas geradas por IA e até gerar mais tráfego de referência. Até agora, porém, não existe nenhuma prova concreta disso. O que vem crescendo, de fato, é o ecossistema de ferramentas em torno do arquivo — o Google Lighthouse, por exemplo, já passou a verificar a presença do llms.txt em auditorias de site. Isso mostra que o assunto está sendo levado a sério, mesmo sem nenhum provedor de modelo ter confirmado oficialmente que usa o arquivo.
Qual problema o llms.txt tenta resolver?
Na prática, o llms.txt busca facilitar a navegação dos robôs de IA, que hoje esbarram em dois obstáculos principais:
- Sites modernos são difíceis de “ler”. A maioria dos rastreadores de IA consegue entender apenas o HTML básico das páginas — não o conteúdo carregado via JavaScript. Por isso, o llms.txt oferece um formato limpo e estruturado, fácil de digerir rapidamente.
- Excesso de informação. Boa parte dos sites tem tanto conteúdo acumulado que os robôs não sabem o que é realmente relevante. Se eles gastam tempo processando páginas antigas e pouco úteis, acabam gerando respostas baseadas em informações defasadas — e é exatamente esse problema que o llms.txt ajuda a resolver.
Além disso, o arquivo pode reduzir ineficiências no rastreamento. Os robôs não têm paciência infinita com o seu site: se um deles gasta o orçamento de rastreamento tentando entender o menu de navegação e o banner de cookies, pode nunca chegar às páginas de produto que você realmente quer que sejam citadas. É aí que o llms.txt entra em cena, apontando o caminho direto para o seu melhor conteúdo — aumentando as chances de ele ser lido, indexado e representado corretamente nas respostas de IA.
Como é estruturado um arquivo llms.txt?
O arquivo deve ser formatado em Markdown, aquela linguagem de marcação leve e em texto simples que os desenvolvedores já usam, por exemplo, nos arquivos README do GitHub — e que é facilmente interpretada por sistemas de IA. O nome do arquivo deve ser salvo em minúsculas, como llms.txt, seguindo a especificação oficial.
Entre os elementos de Markdown mais comuns usados nesse arquivo estão:
- # para o título principal (H1), ## para subtítulos (H2), ### para H3, e assim por diante
- > para citações em destaque, usadas para descrições importantes
- – ou * para marcadores em listas não ordenadas
- [texto](url) para links levando ao conteúdo
- : para adicionar descrições ao lado dos links, explicando aonde eles levam
- “` para blocos de código, quando há exemplos técnicos
A maioria dos arquivos llms.txt segue o mesmo padrão básico: um H1 com o nome do site ou produto, uma citação opcional descrevendo o negócio e, na sequência, seções em H2 agrupando links relacionados — cada um deles apresentado como item de lista com uma breve descrição separada por dois-pontos.
A especificação oficial traz um exemplo bem simples de como o arquivo pode ficar. Mas, se o seu site for grande ou complexo, vale a pena caprichar mais na estrutura — usando H3 e H4 para criar subseções, tabelas para organizar dados ou até blocos de código para demonstrar o uso de APIs. Não há problema nenhum nisso: arquivos Markdown são totalmente legíveis por rastreadores de IA, desde que a sintaxe esteja correta. Aliás, essa estrutura extra pode até dar mais contexto para os robôs entenderem o conteúdo.
As marcas já estão adotando o llms.txt?
Sim, e a adoção vem crescendo rápido. Em julho de 2025, apenas 951 domínios tinham publicado um llms.txt. Em setembro de 2026, esse número já havia saltado para 16.670 — um crescimento de aproximadamente 17,5 vezes em cerca de 14 meses, o que é bastante rápido para uma especificação que nem existia antes do final de 2024.
Ainda assim, é preciso colocar esse número em perspectiva: 16.670 domínios representam uma fatia pequena diante das centenas de milhões de sites ativos pela internet. Ou seja, a curva de crescimento é real, mas a janela de oportunidade continua bem aberta. Quem publica seu llms.txt hoje não está entrando em um mercado saturado — está, na verdade, à frente da grande maioria dos concorrentes.
É possível conferir o arquivo de qualquer site adicionando /llms.txt ao final do domínio (por exemplo, example.com/llms.txt). Veja como algumas marcas organizam o próprio arquivo:
- Hugging Face: foca em documentação para desenvolvedores e usa múltiplos níveis de títulos (#, ##, ###, ####) para separar o conteúdo em seções, além de exemplos completos de código, muitos links e notas explicativas — lembra uma base de conhecimento robusta.
- Vercel: também voltado à documentação técnica, começa com linhas descritivas como title:, description: e tags:, e organiza o conteúdo em seções lógicas com instruções passo a passo e exemplos práticos de código.
- Zapier: aposta em uma estrutura bem mais simples, basicamente uma longa lista de links com descrições ao lado explicando para onde cada um leva.
- Cal.com: usa títulos no topo (#, ##) e parte direto para uma lista de links agrupados em seções com subtítulos.
Repare como cada empresa resolve isso de um jeito diferente — e não há problema nenhum nessa diversidade. Contanto que o Markdown esteja válido, o arquivo continua sendo perfeitamente legível por máquina e processável por sistemas de IA.
Vale a pena usar llms.txt no seu site?
Você pode testar o llms.txt como uma experiência de baixo custo, mas ele não é obrigatório — seu conteúdo continua podendo aparecer em respostas de IA mesmo sem esse arquivo. Deixá-lo pronto custa pouco caso a adoção continue crescendo, mas é importante não esperar resultados imediatos.
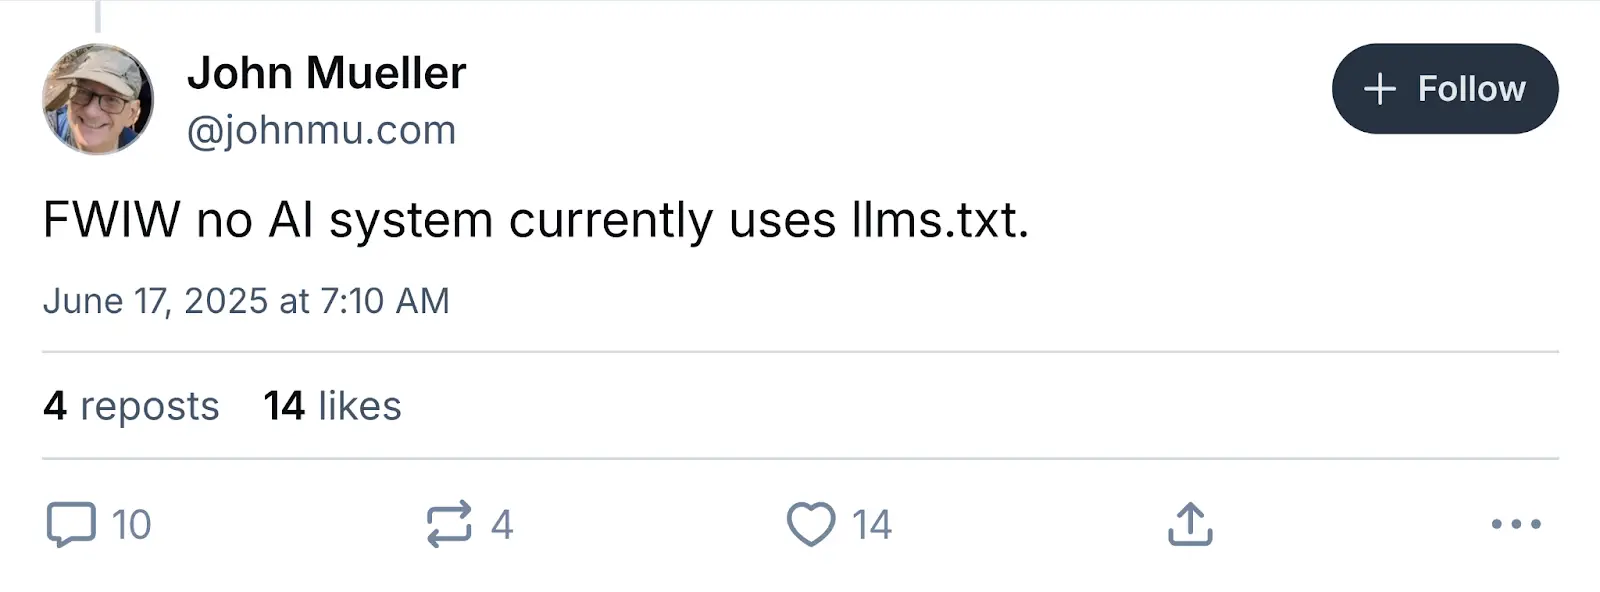
Até o momento, nenhuma grande plataforma de IA — nem ChatGPT, nem os AI Overviews do Google, nem o Claude da Anthropic — confirmou oficialmente que lê ou depende do llms.txt. O próprio John Mueller, do Google, já reforçou esse ponto publicamente no Bluesky.
Ainda assim, há sinais interessantes no horizonte. A Anthropic, por exemplo, publicou um llms.txt em seu próprio site — o que não comprova que o rastreador de IA da empresa realmente utiliza esses arquivos, mas sugere que, no mínimo, a ideia é bem-vinda por lá. O Google, por sua vez, lançou o Open Knowledge Format (OKF), uma especificação aberta para empacotar conteúdo destinado a agentes de IA — embora o OKF não seja exatamente a mesma coisa que o llms.txt.
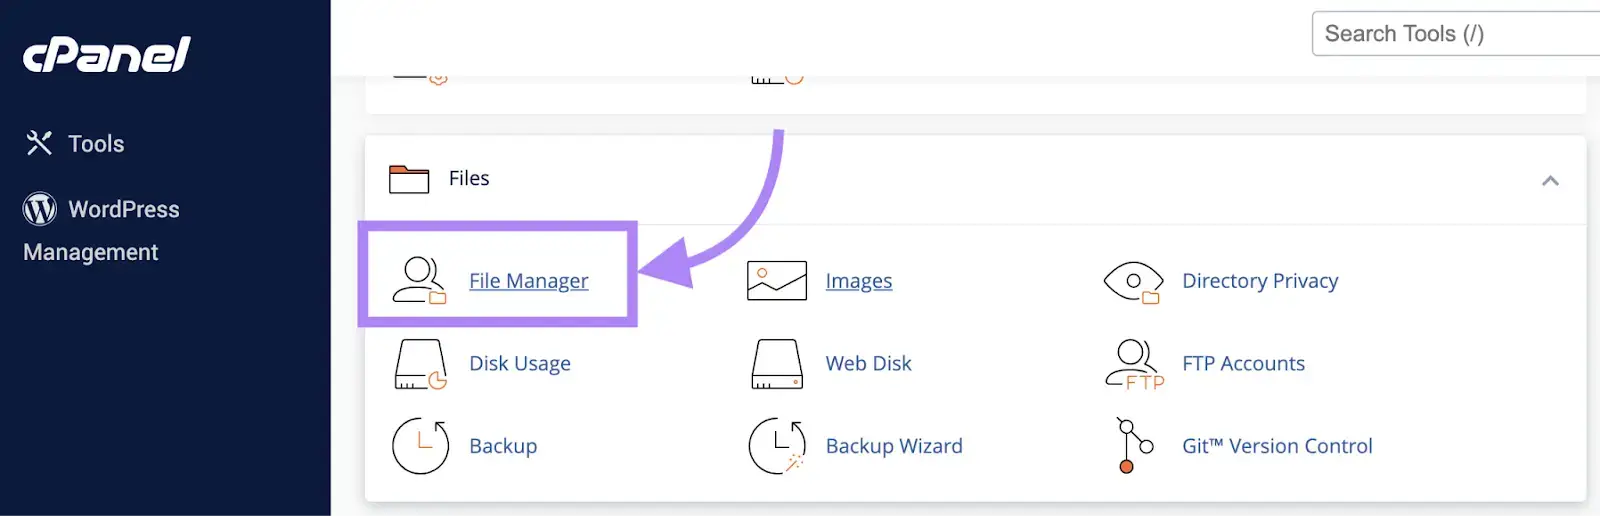
No fim das contas, para quem trabalha com SEO e otimização para buscas de IA, publicar o llms.txt hoje é mais uma aposta estratégica do que uma obrigação técnica. Ninguém garante retorno imediato, mas o custo é baixo e o potencial de ficar à frente da concorrência, ainda que modesto agora, pode valer a experiência.
Com informações de semrush.com.