

Imagine pedir pra alguém fazer compras pra você e essa “pessoa” na verdade ser um robô que entra no site do jeitinho que você entraria, finge que é você e ainda finaliza a compra sozinho. É mais ou menos isso que o Meta Muse e o OpenAI Dots já fazem hoje. Esses agentes de IA pessoais estão dividindo a internet em dois grupos de sites: os que fecharam parceria com esses robôs e os que são simplesmente “visitados” por eles, sem nem saber direito quem entrou.
Tanto o Muse quanto o Dots recebem um pedido de uma pessoa e saem rodando a web pra resolver: pesquisam produto, preenchem formulário e até colocam item no carrinho e fecham o pedido. A Meta já detalhou bastante como o Muse funciona por dentro; a OpenAI, por outro lado, ainda divulgou pouco sobre o Dots, então boa parte das informações aqui gira em torno do Muse, trazendo o Dots sempre que a OpenAI deu alguma pista.
Por que os agentes de IA pessoais mudam o jogo do SEO
A tendência é que esse tipo de agente vire, cada vez mais, a forma como as pessoas usam a internet no dia a dia. Antes do iPhone popularizar a navegação pelo celular, o computador era praticamente a única porta de entrada pros sites. Segundo a contagem da StatCounter, a fatia de tráfego mundial via computador caiu de 98% em janeiro de 2010 pra menos da metade em 2026. A aposta é que o mesmo movimento aconteça agora com os navegadores operados por humanos, perdendo espaço pra navegadores comandados por agentes.
Aquela maratona de comparar preço, reservar e repetir pedido em dez abas do navegador pode virar um único pedido direto pro agente. O Muse, inclusive, já está disponível de graça pra praticamente qualquer uso, para maiores de 18 anos nos Estados Unidos e no Canadá. É justamente por isso que o assunto importa agora, mesmo sem ninguém saber ainda quantas pessoas vão realmente comprar assim.
Para quem trabalha com SEO, a parte em que o agente pesquisa é terreno conhecido — assim como boa parte do que ele lê ao chegar numa página: títulos, textos de link, texto alternativo de imagem e os fatos que aparecem visíveis no conteúdo. Já a etapa de concluir a compra, com botões nomeados, campos preenchidos e checkout, sempre foi território das equipes de front-end.
Um agente dentro de um navegador encontra sites do mesmo jeito que uma pessoa faria: pelo nome ou por busca. Ou seja, o trabalho de ranqueamento continua valendo, mesmo sem a Meta ou a OpenAI revelarem qual motor de busca o agente usa por trás dos panos. Depois que ele chega, é a estrutura da página que decide se o agente consegue ler o conteúdo, interagir com ele e concluir a tarefa — seja uma reserva, um formulário ou uma compra.
Para o pessoal de marketing, a dor de cabeça é outra: atribuição e dados de audiência partem do princípio de que quem visita o site é a pessoa de carne e osso. Quando um agente navega, a tendência é que o seu analytics registre essa visita como se fosse o cliente real. Só que, quando a compra acontece por meio de um conector, o analytics do site não enxerga nada — o pedido aparece só nos registros da própria plataforma de vendas.
Como Muse e Dots chegam até uma loja: conector ou navegador na nuvem
O primeiro nível de acesso do Muse é o conector. A Meta afirma que o Muse “foi lançado com dezenas de parceiros, incluindo acesso a todo o catálogo da Shopify”, e que está expandindo para Walmart, Best Buy, Sephora, Wayfair e outras redes. Para os parceiros que já entraram nessa primeira leva, a Meta diz que “trabalhou de perto com o provedor do serviço para integrar sua API”. O Dots tem sua própria versão disso: segundo a OpenAI, “por meio do nosso ecossistema de plugins, eles conseguem se conectar facilmente a mais de 4.000 aplicativos”. Qualquer empresa pode construir um conector e submetê-lo à revisão da OpenAI.
Quem não tem conector cai no segundo nível: o navegador. Nas palavras da Meta, o Muse roda “um navegador de verdade, baseado em Chromium e atualizado”, dentro de “um computador dedicado e seguro”. Já a OpenAI descreve que o Dots “consegue fazer praticamente tudo usando seu próprio computador na nuvem, seu próprio navegador e os aplicativos conectados”. A documentação da Meta voltada a empresas que querem construir conectores é direta: “O Muse já consegue navegar em sites. Seu conector deve melhorar o que já é possível na experiência via navegador, com informações melhores, acesso à conta, ações mais confiáveis ou menos etapas.” Sem conector, o agente chega ao site pelo navegador porque alguém pediu uma tarefa — comprar uma camisa de um estilista específico, por exemplo — e ele se vira com o que a página oferece.
Lojas na Shopify têm um detalhe importante: a própria plataforma pode escolher o nível por elas. A configuração padrão, “Allow Shopify to manage for me”, encontrada em Sales channels e depois em Agentic, já matricula a loja nos canais de compras via IA. A Shopify confirma que os produtos “são compartilhados com a Meta por padrão através do Shopify Catalog”. Já uma loja em plataforma própria fica automaticamente no nível de navegador, a menos que construa um conector próprio.
Sem nome pra colocar no robots.txt: o desafio do controle de acesso
A maioria dos controles usados por quem trabalha com SEO — das regras de robots.txt às listas de permissão de crawlers — foi pensada pra rastreadores que se identificam. O problema é que nem a Meta nem a OpenAI publicaram um user agent, cabeçalho de requisição ou assinatura específica para os navegadores do Muse ou do Dots. Ou seja, não existe nome pra escrever no robots.txt. A página da Meta voltada a donos de site lista cinco crawlers, e o Muse não está entre eles; a página da OpenAI lista quatro, e o Dots também fica de fora.
A própria Meta explica o que um site enxerga quando o Muse aparece: “Quando o Muse navega pela internet, isso vai aparecer como sua atividade, então, se você pedir ao Muse para comprar uma camisa no site de um estilista, esse estilista pode usar sua visita para te mostrar um anúncio no Instagram.”
É como o personagem Frank Abagnale em “Prenda-me Se For Capaz”: ele andava pelos aeroportos vestido de piloto e ninguém checava se ele realmente sabia pilotar, porque o uniforme já bastava. O Muse entra no seu site vestido com o uniforme do seu cliente e, nas palavras da própria Meta, como “sua atividade”. O robots.txt sempre dependeu de nomes, e esse visitante simplesmente não dá nenhum.
O padrão do robots.txt deixa claro que suas regras “não são uma forma de autorização de acesso” — um rastreador só as segue se seu operador decidir respeitá-las.
Ter um nome é o que permite a um site reconhecer o visitante e decidir o que fazer com ele. A Amazon, por exemplo, lista 99 agentes no seu robots.txt, e nem Muse nem Dots aparecem ali, simplesmente porque não há nome pra escrever. Quando a Amazon bloqueou o Muse, fez isso por outro caminho: pelas suas Condições de Uso, o contrato que o próprio cliente aceita. O GeekWire noticiou os três motivos do bloqueio: a Meta não avisou a Amazon que o Muse acessaria sua loja, o agente não se identifica enquanto navega e ele parece capturar e armazenar credenciais de clientes.
O Dots tem uma segunda rota possível. A documentação da OpenAI orienta os usuários: “Se um site bloquear o navegador na nuvem, peça ao seu dot para tentar pelo seu computador conectado.” E, de forma mais ampla sobre o uso de computador pelo ChatGPT, a OpenAI afirma que sites “podem tratar cliques aprovados, envios de formulário e ações autenticadas como vindas da sua própria conta.”
Na prática, para as equipes de SEO, a decisão deixa de ser sobre robots.txt e passa a depender da proteção contra bots — e isso, em geral, é um sistema gerenciado por outra área. Um firewall ou o filtro de bots da própria plataforma enxerga apenas um navegador Chromium rodando numa máquina na nuvem, e precisa decidir: bloqueia ou deixa passar como se fosse gente de verdade.
A HUMAN Security, segundo reportagem da PPC Land, afirma que seu produto de detecção de bots consegue identificar o Muse — um bom motivo pra perguntar ao seu fornecedor de proteção contra bots se ele é capaz de distinguir quando um navegador Chromium está sendo operado por humano ou por agente de IA.
O que o SEO on-page ainda consegue controlar
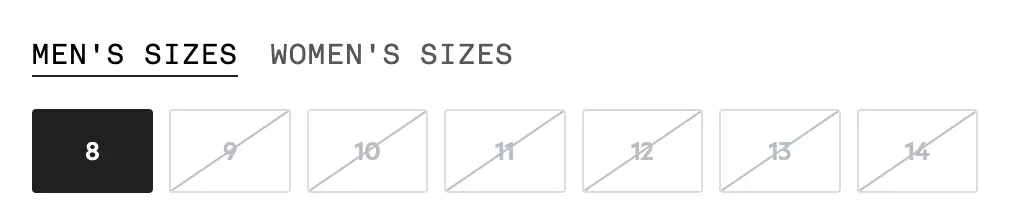
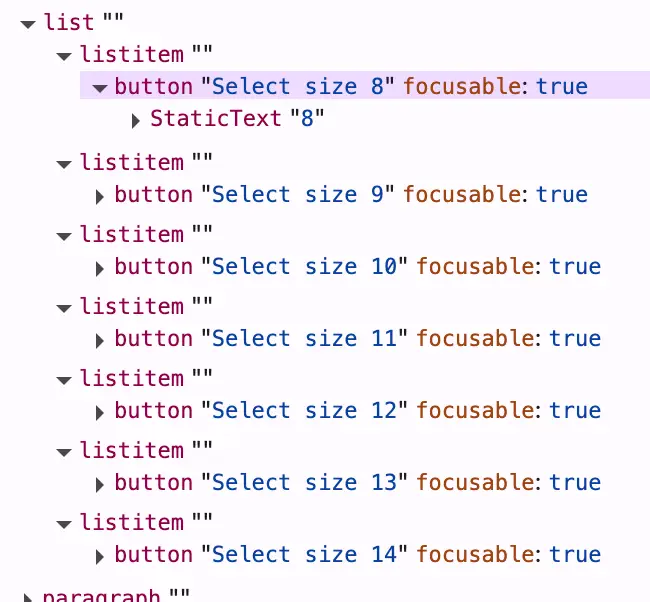
A Meta explica que o sub-agente de navegação do Muse lê a página através da árvore de acessibilidade: “o sub-agente, que comanda o navegador, enxerga um snapshot da árvore de acessibilidade da página, não o DOM bruto.” Esse sub-agente também “não tem capacidade de executar JavaScript no contexto da página” — os scripts do próprio site continuam rodando normalmente, já que se trata de um navegador real, mas o Muse não consegue adicionar nenhum script por conta própria. A OpenAI, por sua vez, ainda não detalhou como o navegador do Dots lê uma página. Já a orientação da própria Google para donos de site aponta que agentes de navegador podem coletar o que precisam “analisando renderizações visuais (como capturas de tela), inspecionando a estrutura do DOM e interpretando a árvore de acessibilidade.”
A árvore de acessibilidade é a mesma estrutura usada por leitores de tela, e o navegador a constrói a partir do DOM. Em resumo, isso significa que boas práticas básicas de SEO on-page — hierarquia clara de títulos, textos alternativos bem descritos, links com texto significativo — continuam sendo a base que garante que esses agentes consigam ler e operar corretamente numa página, mesmo sem enxergar o código bruto por trás dela. Apesar de todas as incertezas sobre nomes de user agent e regras de bloqueio, uma coisa já fica clara: cuidar da estrutura semântica do site deixou de ser só uma boa prática de acessibilidade e virou também uma questão estratégica para quem não quer ficar de fora dessa nova forma de navegar e comprar.
Com informações de searchenginejournal.com.