

Entender de onde vem a informação do ChatGPT ajuda a explicar por que a ferramenta às vezes acerta em cheio e, outras vezes, erra feio sobre fatos recentes. A OpenAI, empresa responsável pelo chatbot, estrutura as respostas a partir de quatro fontes diferentes, e cada uma delas é acionada conforme o tipo de pergunta feita pelo usuário.
Essa divisão interfere diretamente em quem usa a ferramenta no dia a dia, seja para pesquisar produtos, acompanhar notícias ou buscar dados técnicos. Saber como o sistema escolhe de onde tirar a resposta também importa para empresas e sites que querem aparecer (ou não) nas respostas geradas pela inteligência artificial.
Quais são as fontes de informação do ChatGPT?
De acordo com a documentação da OpenAI, o ChatGPT recorre a quatro origens de dados:
- Os dados usados no treinamento do modelo, antes do seu lançamento
- Buscas ao vivo na web, feitas quando o sistema precisa de informações atuais
- Conteúdo de veículos de imprensa com os quais a OpenAI tem acordos de licenciamento
- O contexto fornecido pelo próprio usuário, como prompts, arquivos enviados, memória de conversas e aplicativos conectados
A escolha entre essas fontes depende da pergunta. Questões simples, como definições, tendem a ser respondidas só com o conhecimento do treinamento. Já perguntas sobre preços, notícias ou recomendações atuais costumam disparar uma busca na internet.
Como funciona o treinamento do modelo?
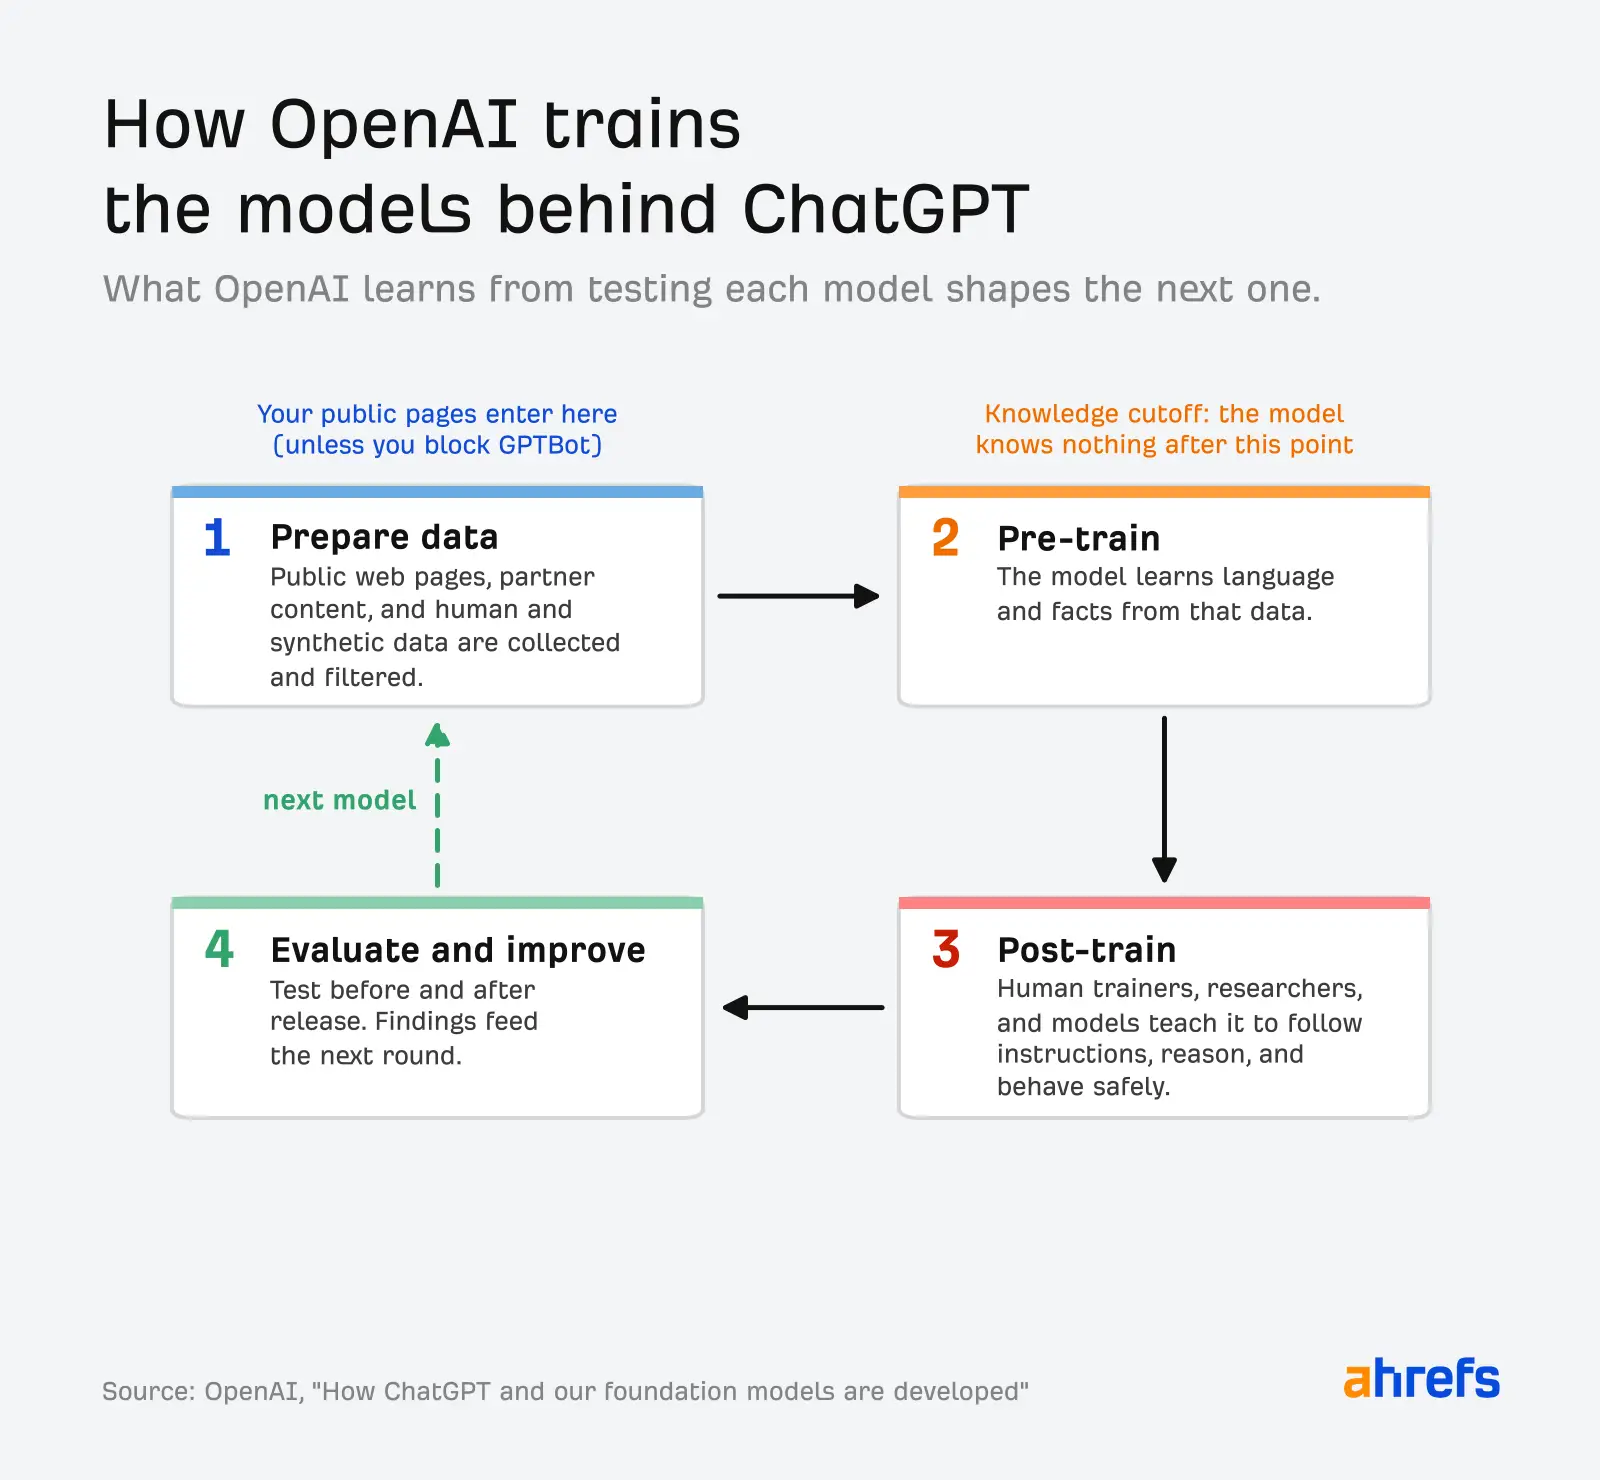
Antes de qualquer lançamento, os modelos por trás do ChatGPT passam por um treinamento com grande volume de dados. É dessa etapa que vem o conhecimento geral do sistema: como a linguagem funciona, fatos sobre o mundo, lógica de programação e outras noções amplas.
Segundo a OpenAI, esse treinamento usa três tipos de dado: informações públicas disponíveis na internet, conteúdo obtido por meio de parcerias com terceiros e material fornecido ou gerado por usuários, treinadores humanos e pesquisadores.
A última vez que a OpenAI detalhou publicamente essa composição foi em 2020, com o modelo GPT-3. Na ocasião, a empresa informou que cerca de 60% da base vinha do Common Crawl (uma grande raspagem pública da web), 22% de páginas linkadas em posts do Reddit com muitos votos positivos, 16% de duas coleções de livros e 3% da Wikipédia. De lá para cá, a OpenAI passou a divulgar cada vez menos detalhes: o documento técnico mais recente da empresa cita apenas que os modelos “foram treinados em conjuntos de dados diversos”, sem especificar quais.
A OpenAI também afirma que não busca, de forma intencional, conteúdo protegido por paywall ou proveniente da dark web, e que filtra material como discurso de ódio, conteúdo adulto, sites que reúnem dados pessoais e spam. Além disso, a empresa diz usar cada vez mais dados sintéticos, ou seja, conteúdo gerado pelos próprios modelos da OpenAI, como exemplos de prática em idiomas com pouco material disponível.
Dá para impedir que o ChatGPT use um site no treinamento?
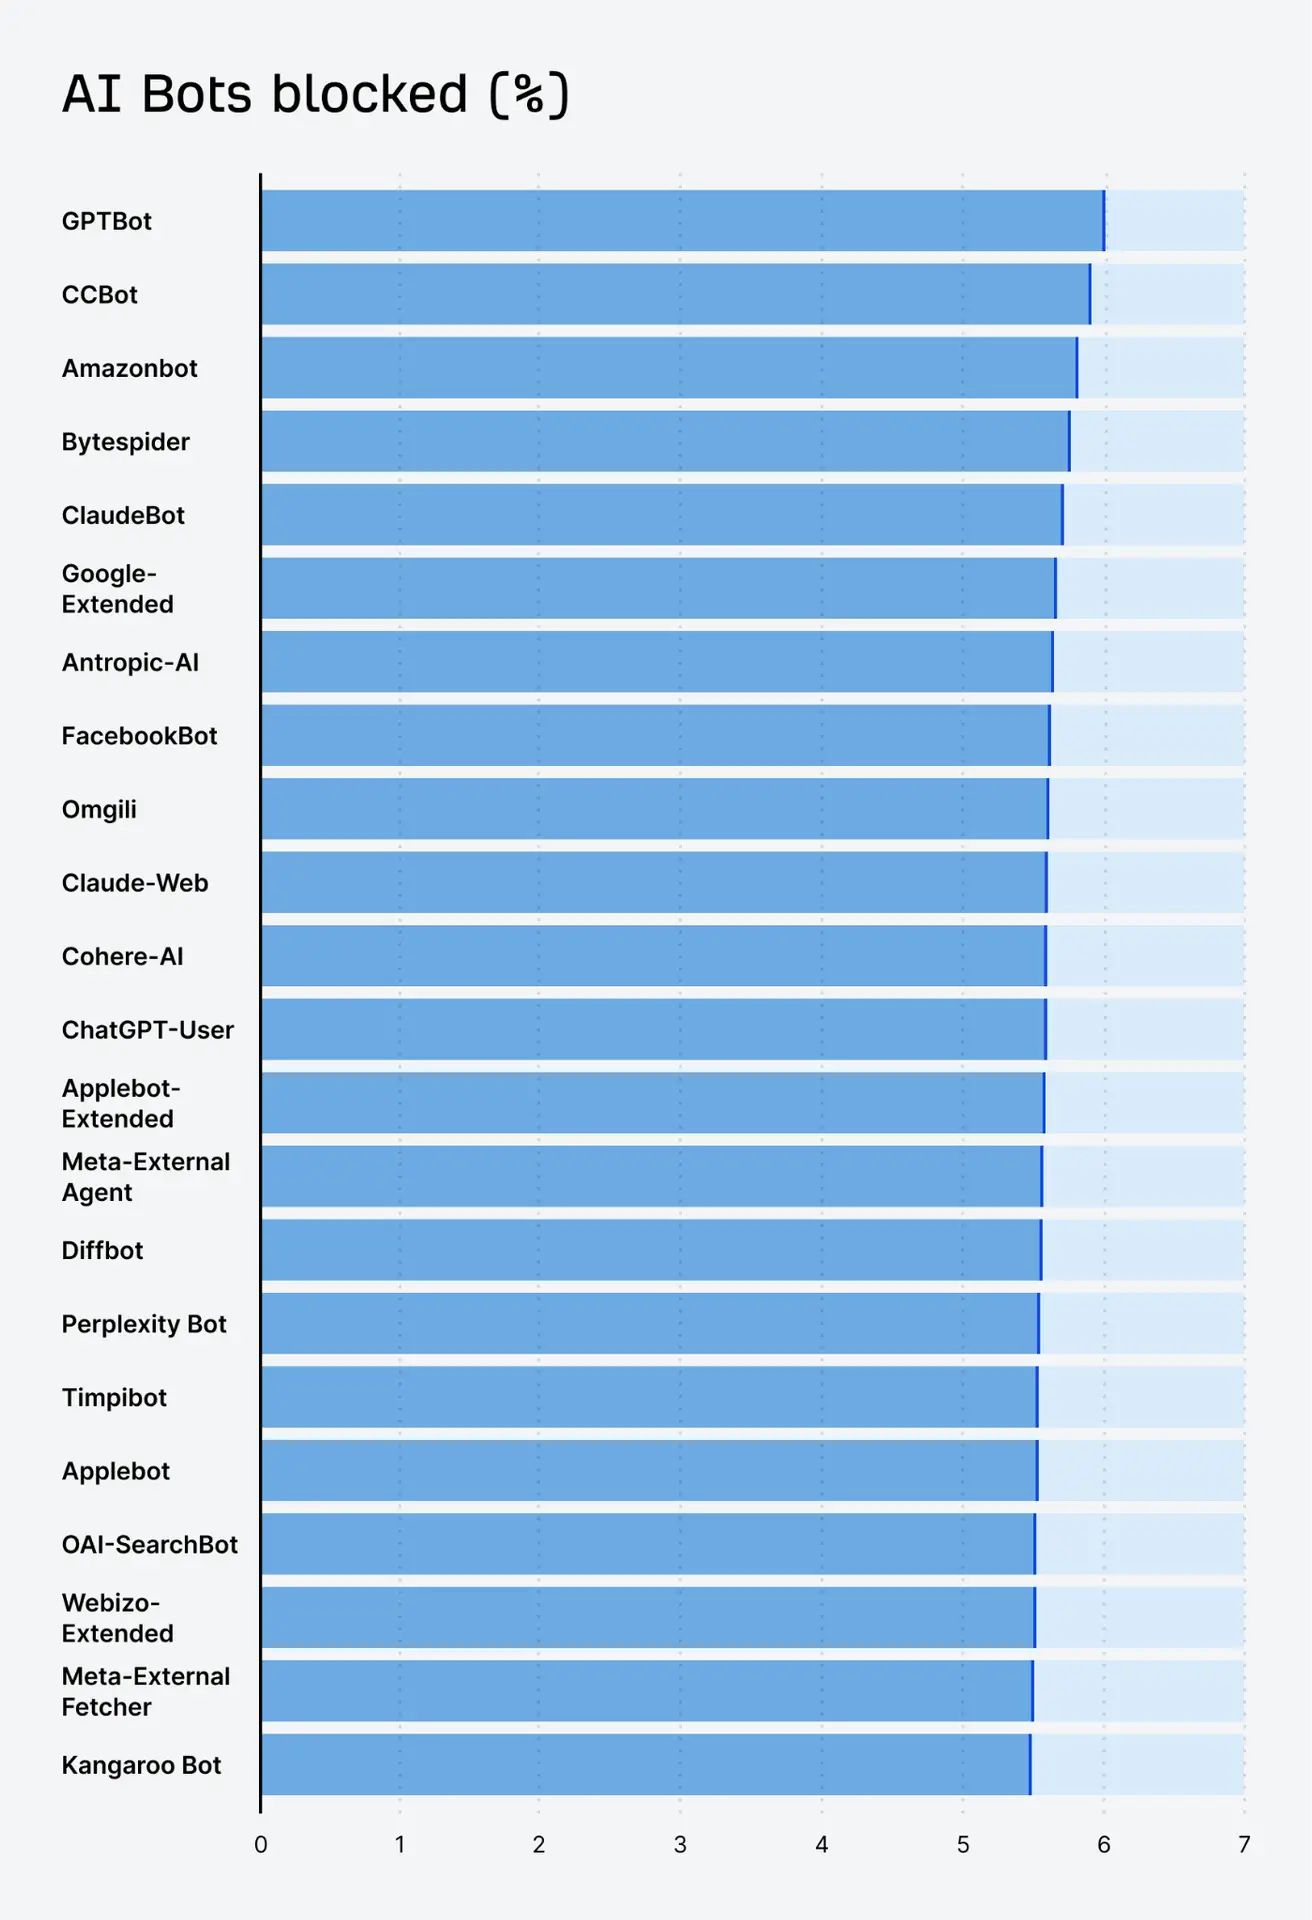
Sim. Segundo o material da OpenAI, donos de sites podem bloquear o GPTBot, o rastreador usado para coletar dados de treinamento, diretamente pelo arquivo robots.txt. Esse bloqueio não tira o site dos resultados de busca do ChatGPT, já que essa função usa um rastreador diferente, o OAI-SearchBot. As duas configurações funcionam de forma independente.
Quem usa o ChatGPT também pode desativar a opção “Melhorar o modelo para todos” nas configurações de dados da conta. Segundo a OpenAI, conteúdos de contas empresariais (Business, Enterprise, Edu e ChatGPT for Healthcare) já não entram no treinamento por padrão.
O lado negativo de bloquear o rastreador é que os modelos futuros aprendem menos sobre aquele site. Para marcas que querem ser reconhecidas pelo ChatGPT, manter o acesso aberto tende a ser mais vantajoso.
O que é o corte de conhecimento do ChatGPT?
O corte de conhecimento marca a data em que os dados de treinamento do modelo param. Depois dele, o ChatGPT só sabe de fatos recentes se fizer uma busca na web. Segundo a OpenAI, os modelos atualmente em uso têm cortes em abril e maio de 2026, variando conforme o plano contratado pelo usuário.
Como funciona a busca ao vivo na web?
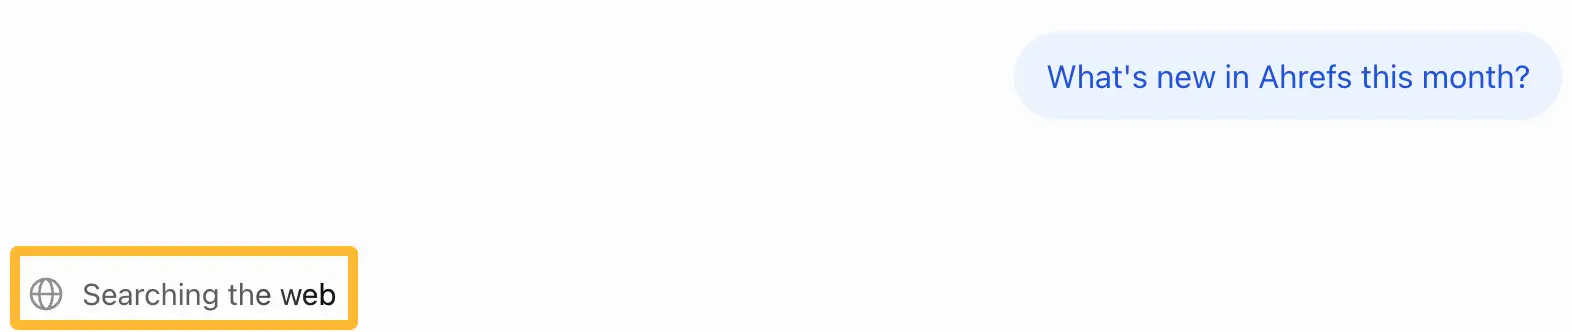
Como o treinamento sempre fica desatualizado em relação ao momento do lançamento, o ChatGPT busca na internet para responder perguntas sobre preços, notícias, produtos ou qualquer assunto recente. Esse mecanismo é chamado de geração aumentada por recuperação (RAG): o sistema primeiro busca a informação e só depois gera a resposta com base no que encontrou.
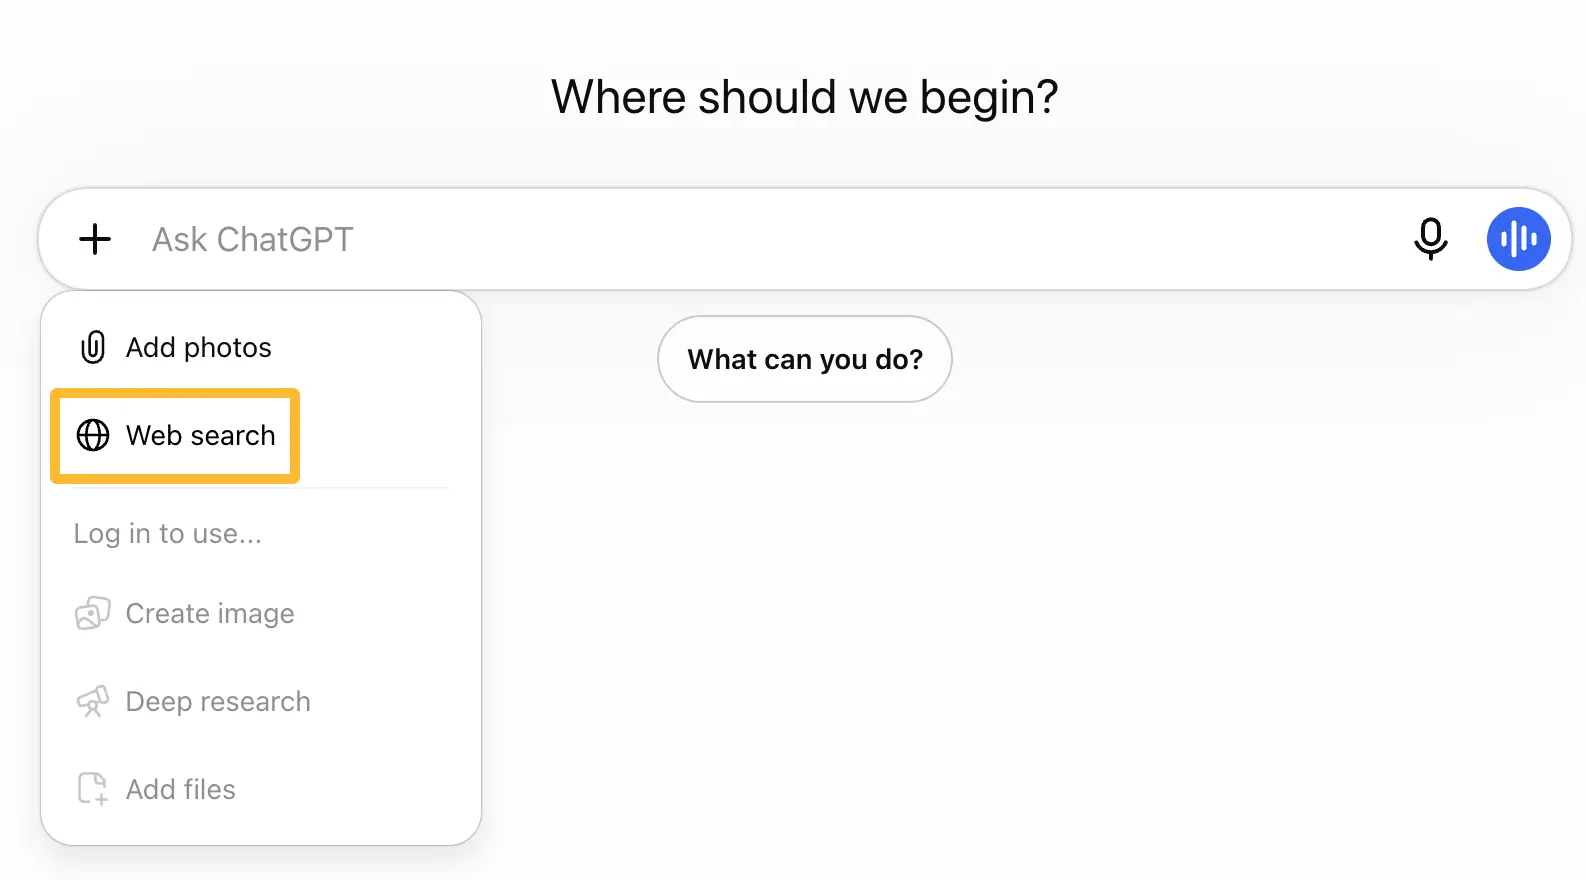
A OpenAI afirma que o ChatGPT pode buscar automaticamente “quando a pergunta se beneficiaria de informação atual”, mas o usuário também pode acionar a busca manualmente pela opção Search.
Em um teste com 12 perguntas feitas a um ChatGPT sem login, nove delas resultaram em busca na web, incluindo questões sobre eventos atuais, preços, recomendações de produtos e pedidos que exigiam fontes. Apenas perguntas de definição simples foram respondidas só com o conhecimento do treinamento.
De acordo com Adam Fry, líder de produto do ChatGPT para consumidores, em declaração à Big Technology, as buscas feitas pelo ChatGPT já somam cerca de um quinto do volume de buscas do Google. Dados internos da OpenAI, batizados de OpenAI Signals, indicam que cerca de uma em cada cinco mensagens de usuários do plano consumidor (20,2% em setembro de 2026) são pedidos de busca por informação.
O que é o “fan-out” de buscas do ChatGPT?
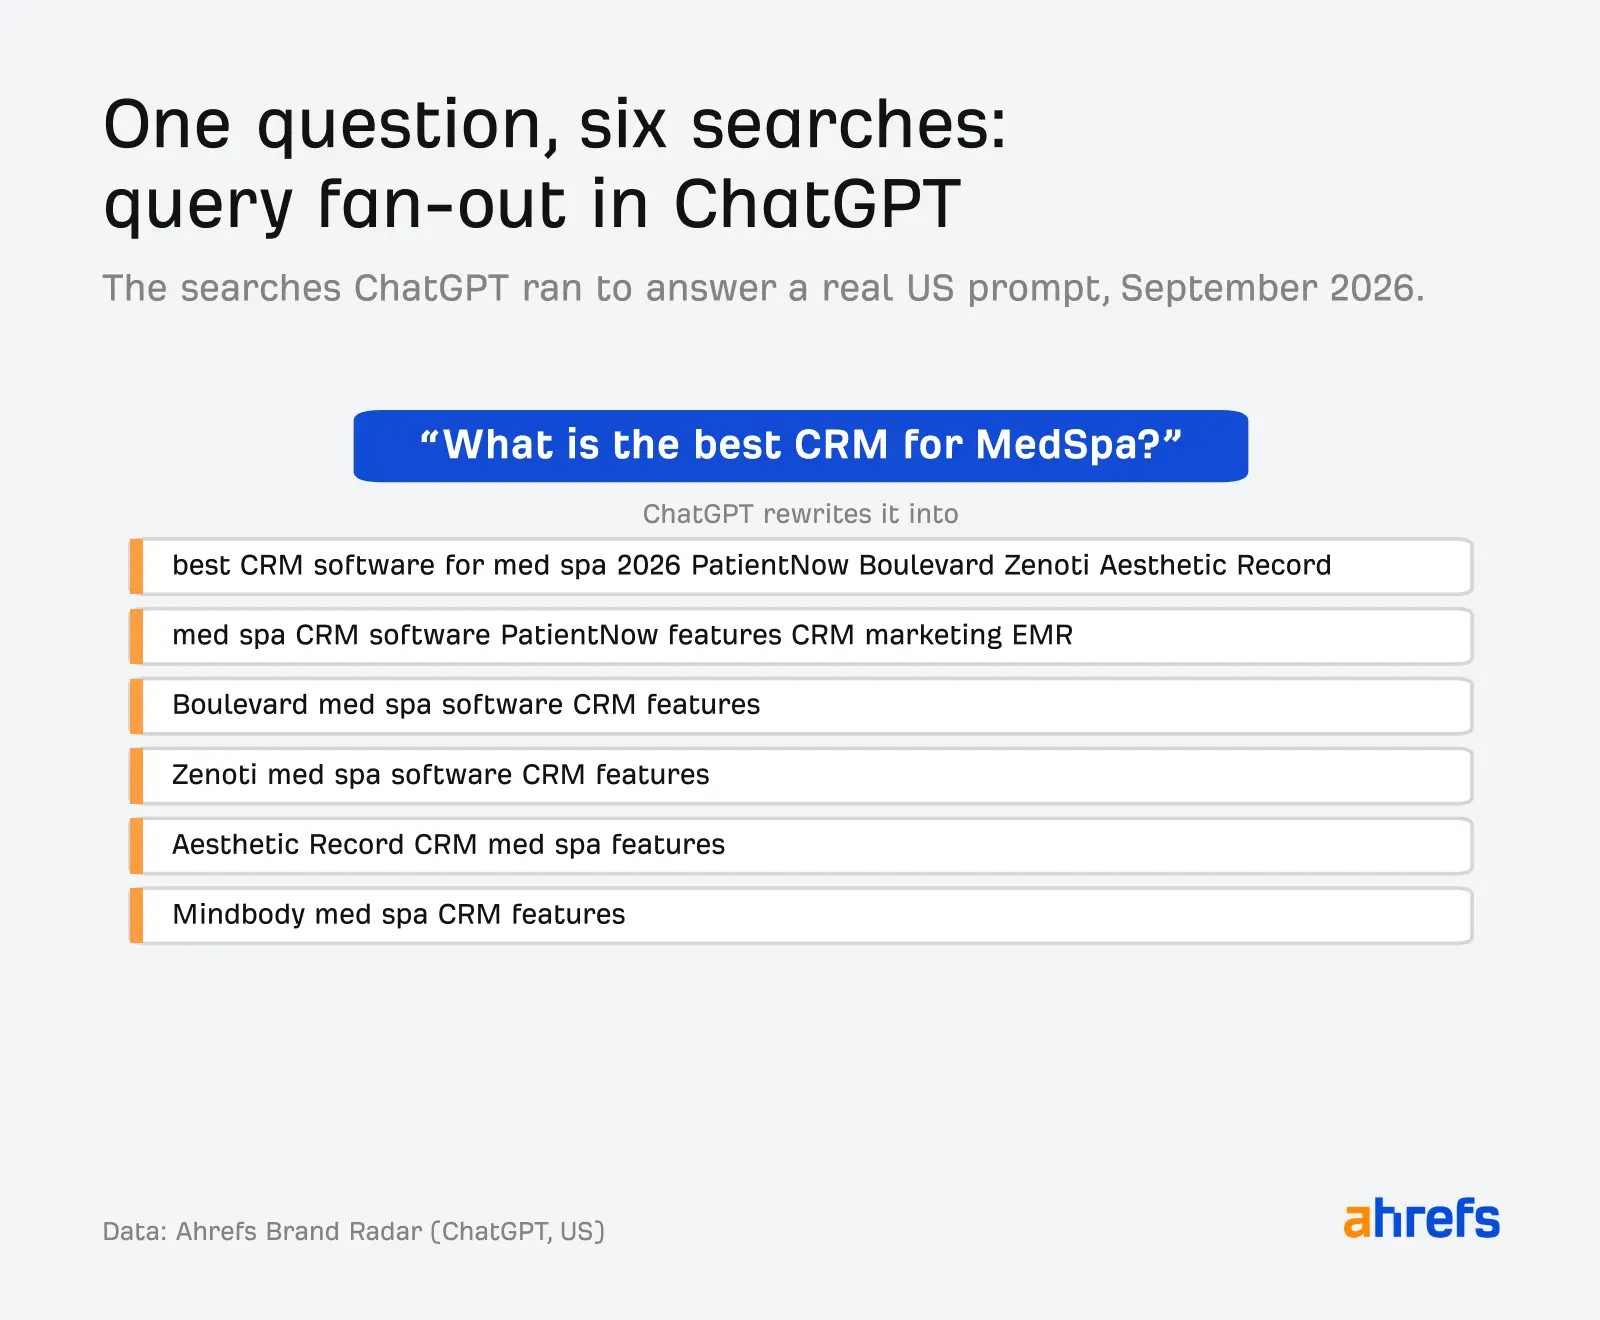
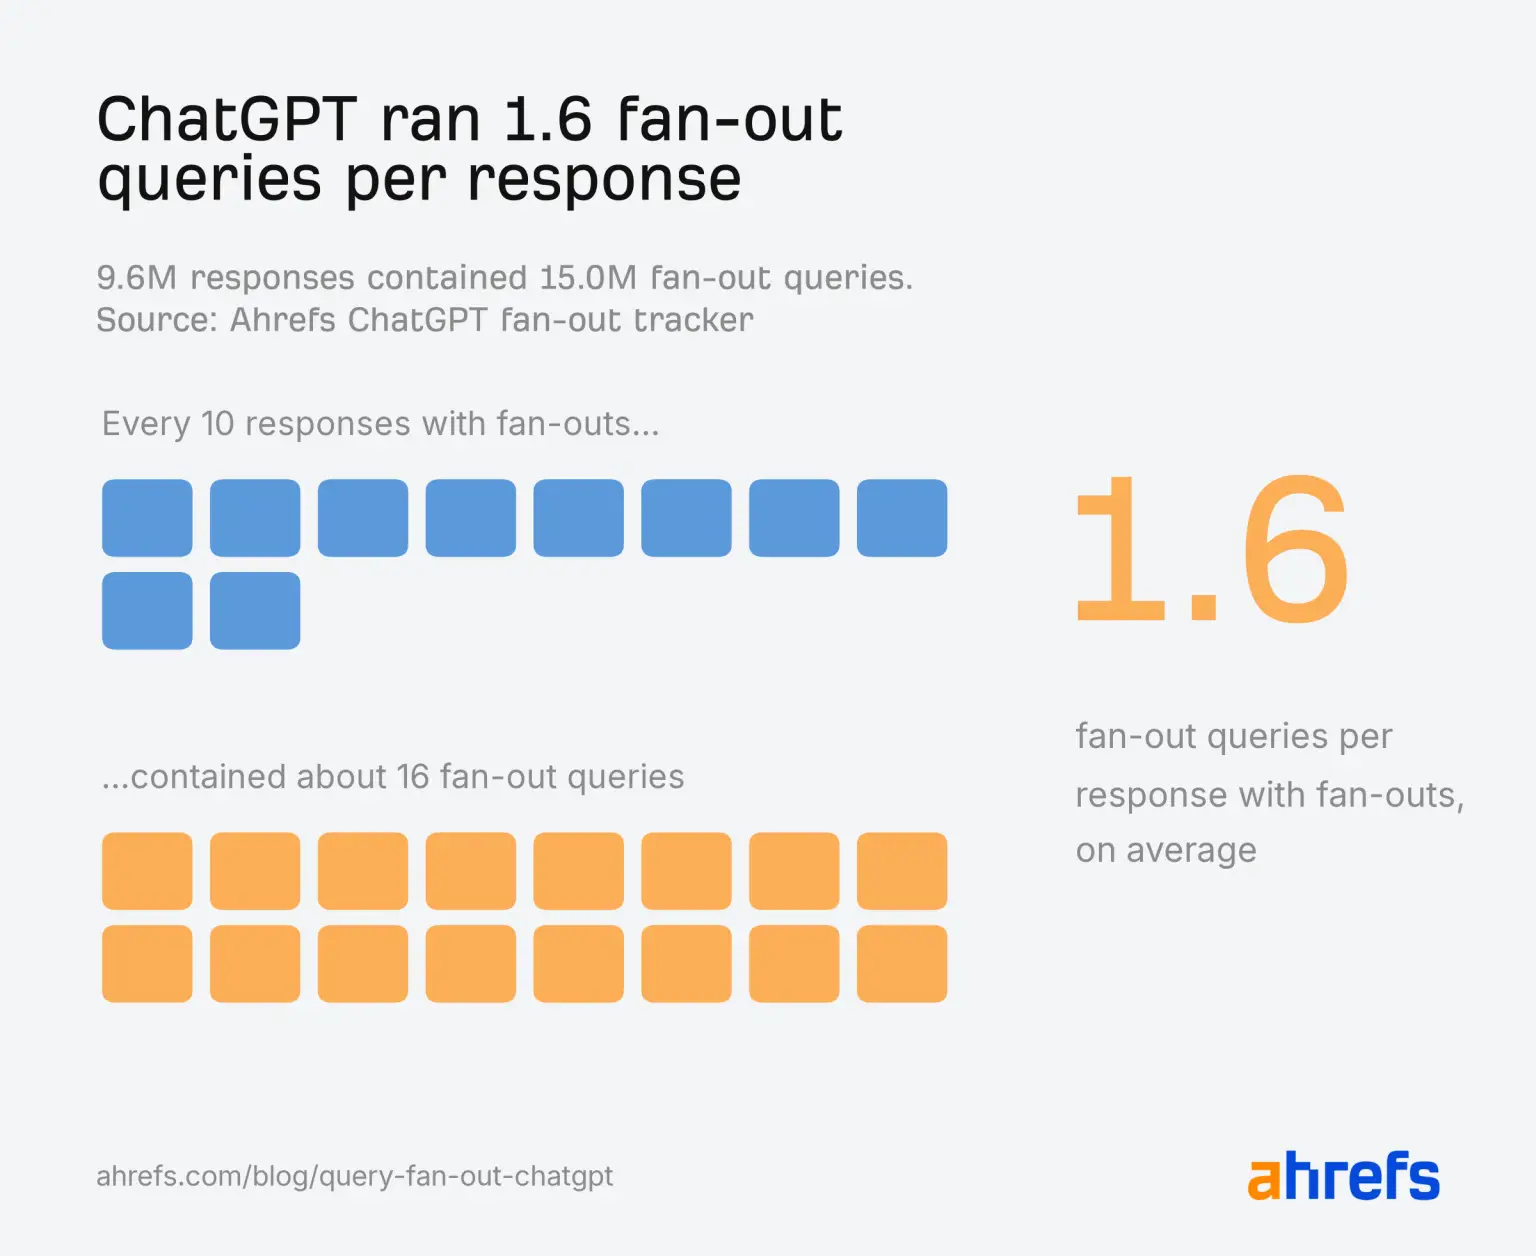
Segundo a OpenAI, o ChatGPT não digita a pergunta do usuário direto em um mecanismo de busca. Em vez disso, ele reescreve o prompt em uma ou mais buscas mais específicas, processo chamado de query fan-out. Uma pergunta como “melhor CRM para uma pequena agência” pode se desdobrar em buscas separadas sobre preços, comparações entre ferramentas e avaliações de usuários.
Por que isso importa para quem tem um site?
A forma como o ChatGPT escolhe suas fontes afeta diretamente a visibilidade de marcas e publicações na internet. Aparecer bem posicionado nos resultados de busca usados pelo ChatGPT, manter o site acessível aos rastreadores da OpenAI e firmar parcerias de licenciamento são, hoje, os principais caminhos para influenciar o que a ferramenta diz sobre um assunto. Já o contexto trazido pelo próprio usuário, como um link colado na conversa ou um arquivo enviado, só entra em jogo quando alguém decide incluir essa informação manualmente.
Com informações de ahrefs.com.