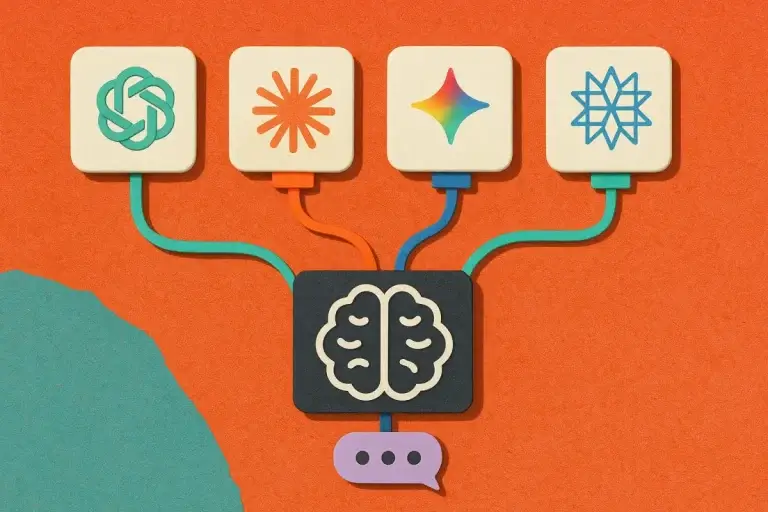


Se você já leu sobre GEO (Generative Engine Optimization), provavelmente já cansou de ouvir que “a busca por IA está mudando tudo”. O que falta na maioria desse conteúdo é algo mais prático: entender como ChatGPT, Claude, Gemini e Perplexity realmente escolhem o que mostrar numa resposta. Afinal, tratar “otimizar para IA” como se fosse uma estratégia única — quando na prática são quatro motores com lógicas diferentes — é um erro comum que compromete qualquer tentativa séria de GEO por motor de IA.
Antes de qualquer coisa, vale um alerta: ninguém fora da OpenAI, da Anthropic, do Google e da Perplexity conhece a fórmula exata que cada um desses sistemas usa para ranquear ou selecionar conteúdo. São sistemas proprietários e que mudam constantemente. O que dá para fazer é mapear os mecanismos documentados que esses motores compartilham, onde eles realmente se diferenciam na prática e o que isso significa para quem trabalha com visibilidade em buscas de IA.
Por que os motores de IA não são todos iguais
Todo grande motor de IA do mercado segue basicamente a mesma receita: pré-treinamento com uma quantidade enorme de texto, ajuste por instruções para o modelo aprender a seguir comandos, otimização de preferências para moldar o comportamento e, por fim, decisões em nível de produto sobre o que buscar e priorizar quando alguém faz uma pergunta. É justamente essa base compartilhada que explica por que tanta dica de GEO soa intercambiável — e também por que ela costuma falhar na hora de testar contra um motor específico.
Cada plataforma, no entanto, direciona essa receita para um objetivo diferente. A Perplexity construiu seu produto em torno de busca com fontes, então as respostas lembram mais um assistente de pesquisa do que um chat comum: cheias de citações e ancoradas no que está disponível na web no momento. Já a Claude foi ajustada para ir fundo, raciocinando em problemas de várias etapas, mantendo contexto em documentos longos e funcionando bem em fluxos de trabalho com agentes, onde a precisão importa a cada passo. O ChatGPT cobre a maior área de uso do grupo, com a maior base de usuários e recursos de voz, visão e multimodalidade sobre um núcleo generalista. Já a vantagem do Gemini aparece na hora em que a tarefa envolve o próprio ecossistema do Google, seja Docs, Sheets, YouTube ou dados do Workspace que os outros três simplesmente não enxergam.
Nada disso é questão de gosto. Uma lista genérica de “boas práticas de GEO” simplesmente ignora esse ponto, porque as diferenças entre esses sistemas vêm de como cada um foi construído e do que foi treinado para recompensar — não de escolhas superficiais de estilo.
Como a IA generativa decide o que dizer
A tomada de decisão dentro desses sistemas acontece em três camadas, e entender isso explica boa parte do que parece comportamento imprevisível visto de fora.
A primeira é a moldagem no momento do treinamento. O modelo lê uma quantidade gigantesca de texto durante o pré-treinamento, passa por ajuste de instruções para aprender a seguir comandos e, depois, por otimização de preferências — geralmente RLHF ou RLAIF — para aprender qual de duas respostas possíveis um avaliador humano preferiu. É nessa etapa que se definem os hábitos padrão do modelo: quanto ele hesita, quanto detalhe oferece por conta própria, quão educado soa por padrão.
Em seguida vem a seleção no momento da inferência, que acontece toda vez que você envia um prompt. O modelo avalia e pondera respostas candidatas, geralmente por meio de um modelo de recompensa ou camada de alinhamento treinada com aqueles mesmos julgamentos humanos de preferência.
Por fim, há a recuperação no momento do produto, a camada que mais varia visivelmente entre plataformas. Alguns motores buscam fontes externas no instante em que a pergunta é feita — processo chamado RAG, ou geração aumentada por recuperação —, enquanto outros dependem mais de padrões já incorporados nos pesos do modelo via ajuste fino. Essa camada explica bastante por que alguns produtos parecem mais um mecanismo de busca e outros, mais uma conversa.
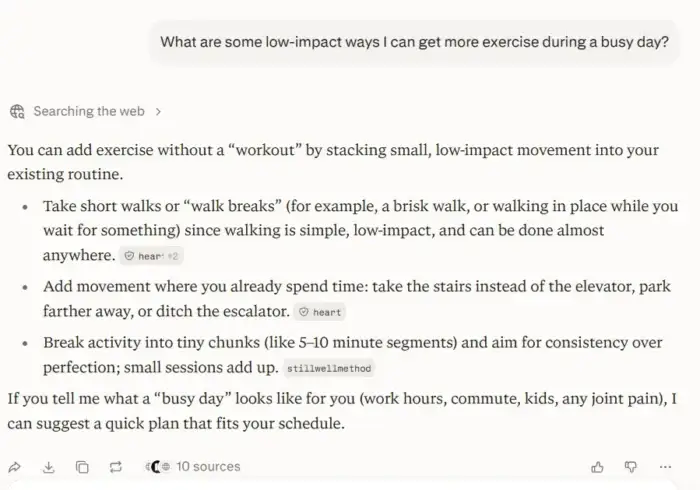
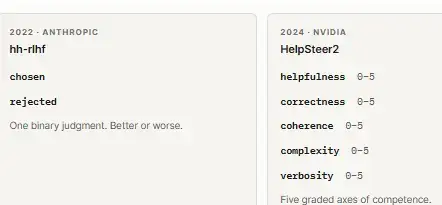
Dois conjuntos de dados públicos ajudam a tornar essa camada de ajuste de preferências algo concreto, e não apenas teórico. A Anthropic publicou o hh-rlhf em 2022: 169 mil linhas, cada uma um julgamento binário sobre qual de duas respostas um avaliador humano preferiu. Já o HelpSteer2, publicado pela Nvidia em 2024, avalia respostas em cinco eixos separados em vez de um só: utilidade, correção, coerência, complexidade e verbosidade.
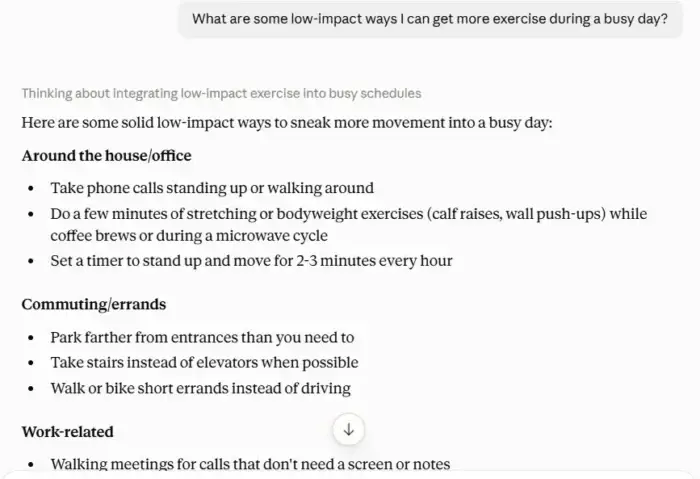
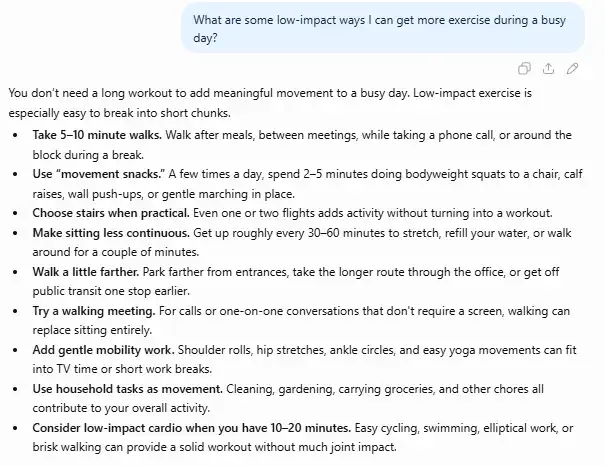
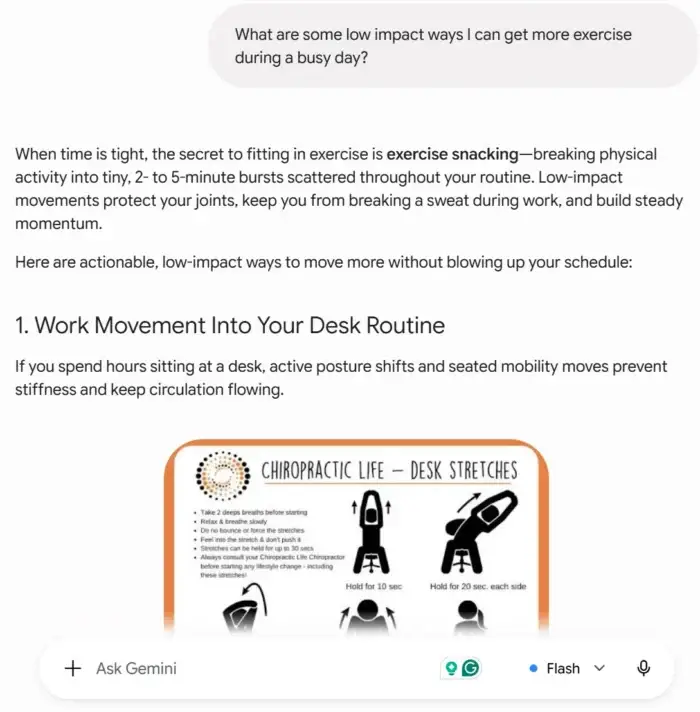
Uma análise independente dos dois arquivos constatou que, sob a nova régua de cinco eixos do HelpSteer2, respostas mais estruturadas em listas pontuaram melhor na maioria dos pares analisados. Isso ajuda a explicar, em parte, por que respostas geradas por IA costumam vir em bullets e passos numerados — mas vale tratar isso como uma inferência bem embasada, não como fato encerrado. O próprio pesquisador responsável pela análise fez questão de apresentar a conclusão com essa ressalva.
Um detalhe importa mais do que os próprios dados: nenhum dos dois arquivos reflete como a Anthropic ou a Nvidia treinam seus modelos hoje. São retratos históricos de um ano específico, em um laboratório específico — não um mapa ao vivo da lógica de ranqueamento de nenhum motor atual. Vale encará-los como uma janela útil e citável sobre como o ajuste de preferências funcionou nesses casos documentados, não como um manual do que está acontecendo agora.
O que muda de um motor de IA para outro
Perplexity: feita para respostas com fontes
Todo o produto da Perplexity gira em torno de citações e busca em tempo real, e isso aparece no resultado final. Testes independentes que rodam ChatGPT, Claude, Gemini e Perplexity com os mesmos lotes de prompts colocam consistentemente a Perplexity à frente em precisão de citação e embasamento em tempo real — o que faz sentido, já que ela busca na web viva no momento da consulta, em vez de depender majoritariamente dos dados de treinamento. Por outro lado, ela deixa a desejar em tarefas criativas ou de formato longo: ao pedir um artigo completo, a saída tende a soar funcional, não polida.
Claude: feita para profundidade
A Claude costuma se destacar em tarefas que exigem manter bastante contexto e raciocinar sobre ele com cuidado. Rodadas de teste que medem calibração — ou seja, com que frequência a confiança do modelo bate com o fato de ele estar realmente certo — colocaram a Claude repetidamente à frente do grupo, principalmente em afirmações nas quais errar realmente pesa. Essa combinação de profundidade e cautela é um dos motivos pelos quais times recorrem à Claude para conteúdo longo e fluxos de trabalho com múltiplos agentes, em vez de respostas rápidas.
ChatGPT: feito para amplitude
O ChatGPT ainda carrega a maior base de usuários do grupo e o conjunto mais amplo de recursos: voz, visão, geração de imagem, navegação e uma longa lista de plugins sobre um núcleo generalista. Essa amplitude é uma vantagem real. Por outro lado, diversos testadores independentes notam que a qualidade da resposta oscila mais do que nos outros três quando o prompt não é bem detalhado. É a ferramenta mais flexível do grupo — e flexibilidade, nesse caso, é faca de dois gumes.
Gemini: feito para o ecossistema Google
A vantagem do Gemini raramente aparece apenas na qualidade bruta do modelo. Ela se revela quando a tarefa envolve dados e serviços que só o próprio Google consegue acessar diretamente, dentro do seu ecossistema de produtos.
No fim das contas, entender essas diferenças é o que separa uma estratégia de GEO por motor de IA genérica de uma que realmente funciona. Em vez de aplicar a mesma receita para todos os canais, faz mais sentido observar onde cada plataforma se destaca — citações em tempo real, raciocínio profundo, amplitude de uso ou integração de ecossistema — e ajustar o conteúdo e a medição de visibilidade (frequência de citação, menções de marca, diversidade de fontes) de acordo com isso. Como os rankings de benchmark mudam a cada poucos meses, vale tratar qualquer comparação como um retrato do momento, não como uma verdade definitiva.
Com informações de neilpatel.com.